導入事例
AI対応データセンターが次世代ワークロードの要求に備えられるよう、Dell TechnologiesとSiemonは、導入前に高速ネットワークファブリックが決定論的かつロスレスなパフォーマンスを発揮できることを証明する必要がありました。両社はKeysightとの協業により、現実的なAIトラフィック条件下でSONiCベースのスイッチングとSiemonの高速接続を検証し、エンドツーエンドのエミュレーションと検証によってリスクを軽減し、AIインフラストラクチャを1.6Tおよびそれ以降へスケールアップできることを実証しました。


大規模AIデータセンターファブリックの検証
導入事例のハイライト:Dell Technologies - Siemon
前へ
- 企業紹介
- 課題
- 解決方法
- 結果

AIインフラのリーダー
Dell Technologies、Siemon、およびキーサイトは、AIデータセンターインフラストラクチャの3つの不可欠なレイヤー、すなわちスイッチングアーキテクチャ、物理接続、およびパフォーマンス検証を代表しています。Dellは、AIファブリックに最適化された高密度スイッチングプラットフォームとSONiCベースのネットワークオペレーティングシステムを提供します。Siemonは、高速銅線、光インターコネクト、および構造化ケーブルシステムを提供します。キーサイトは、高度なトラフィックエミュレーションとベンチマークを通じてシステムレベルの検証を可能にします。

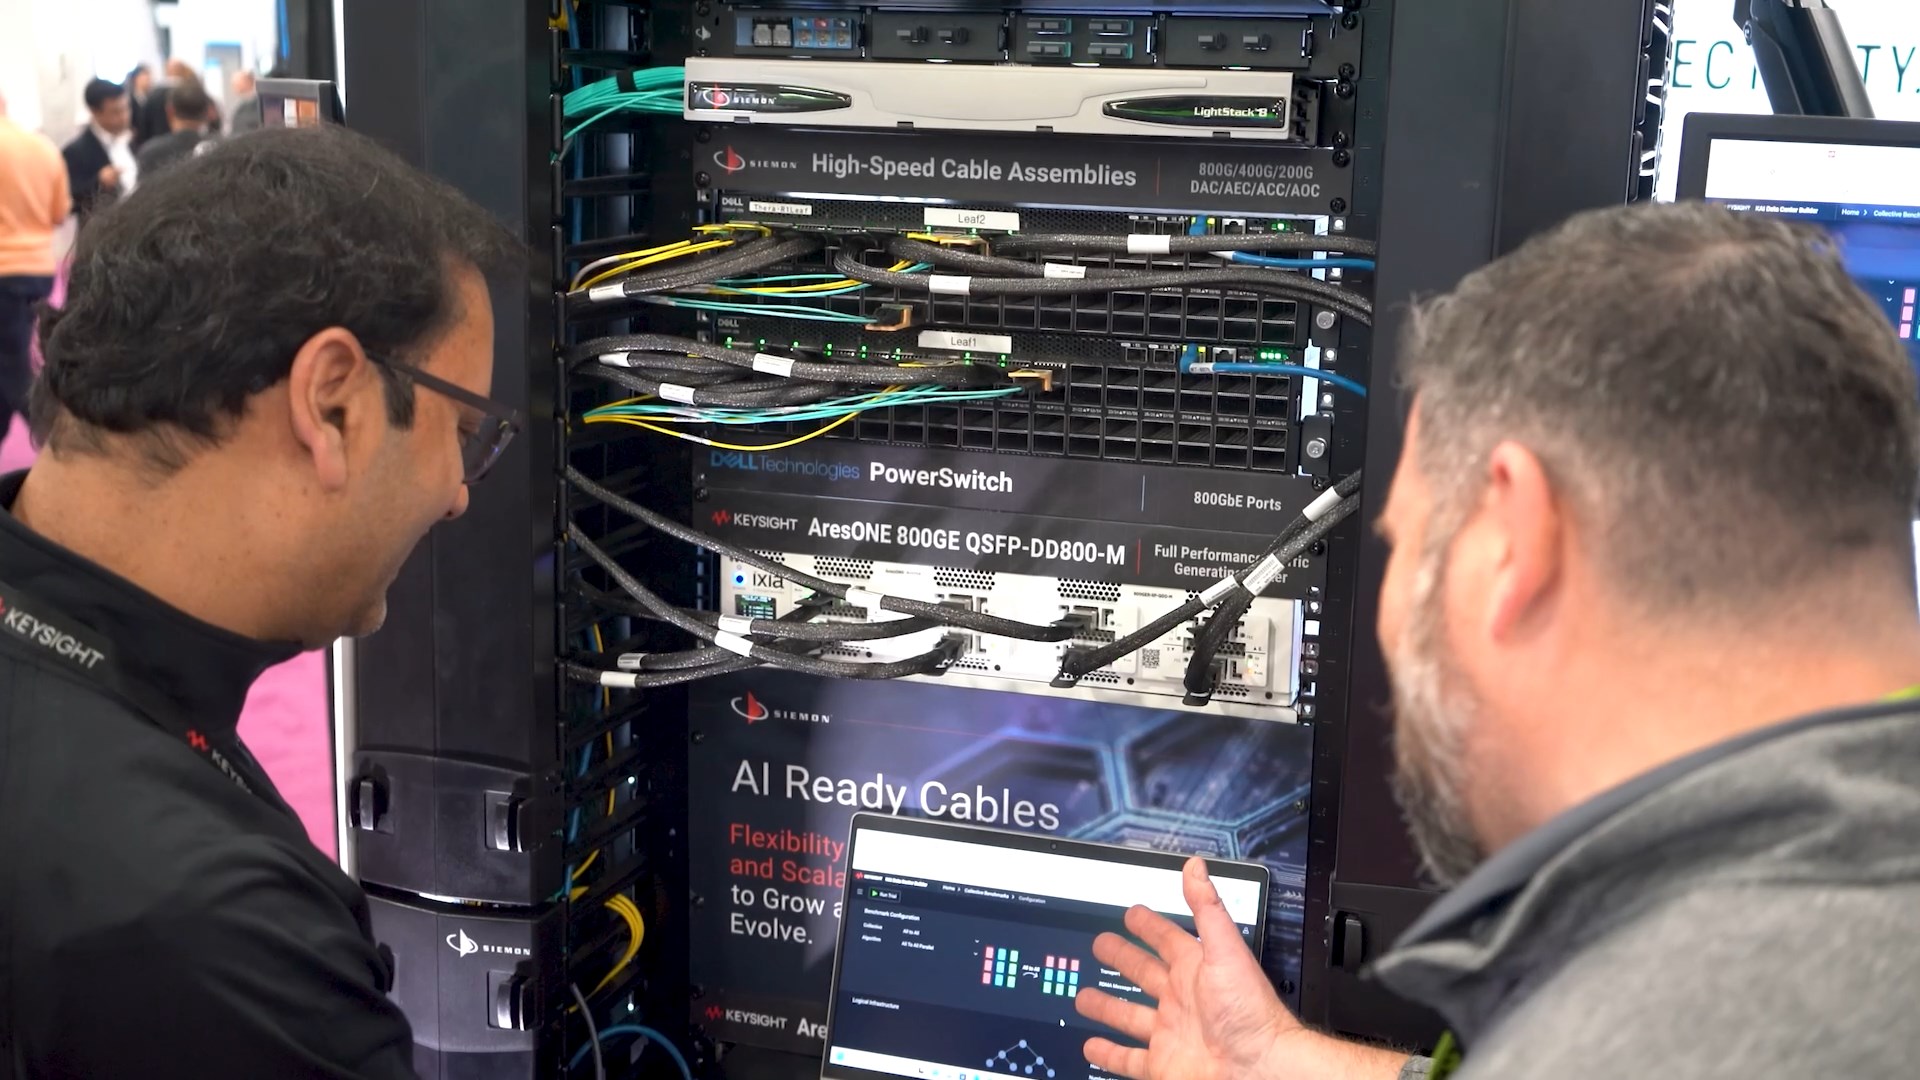
AIネットワークのスケーリング
AIネットワークが大規模化するにつれて、DellとSiemonは、顧客がより高速なファブリックを確信を持って展開できるように支援する必要があります。次世代のAIワークロードは、大規模なイースト・ウエスト・トラフィック、高度に同期されたGPU通信、All-Reduceなどのレイテンシに敏感な集合演算、およびステートフルなRoCEv2動作を引き起こします。これらの要求により、輻輳ホットスポットのリスクが高まり、GPU利用率が低下し、スイッチング、光学部品、およびケーブル配線全体で予測不可能なパフォーマンスが発生します。DellとSiemonにとっての課題は、顧客が大規模に展開する前に、現実的なAIワークロードの条件下でファブリックが決定論的かつロスレスなパフォーマンスを発揮できることを証明することです。

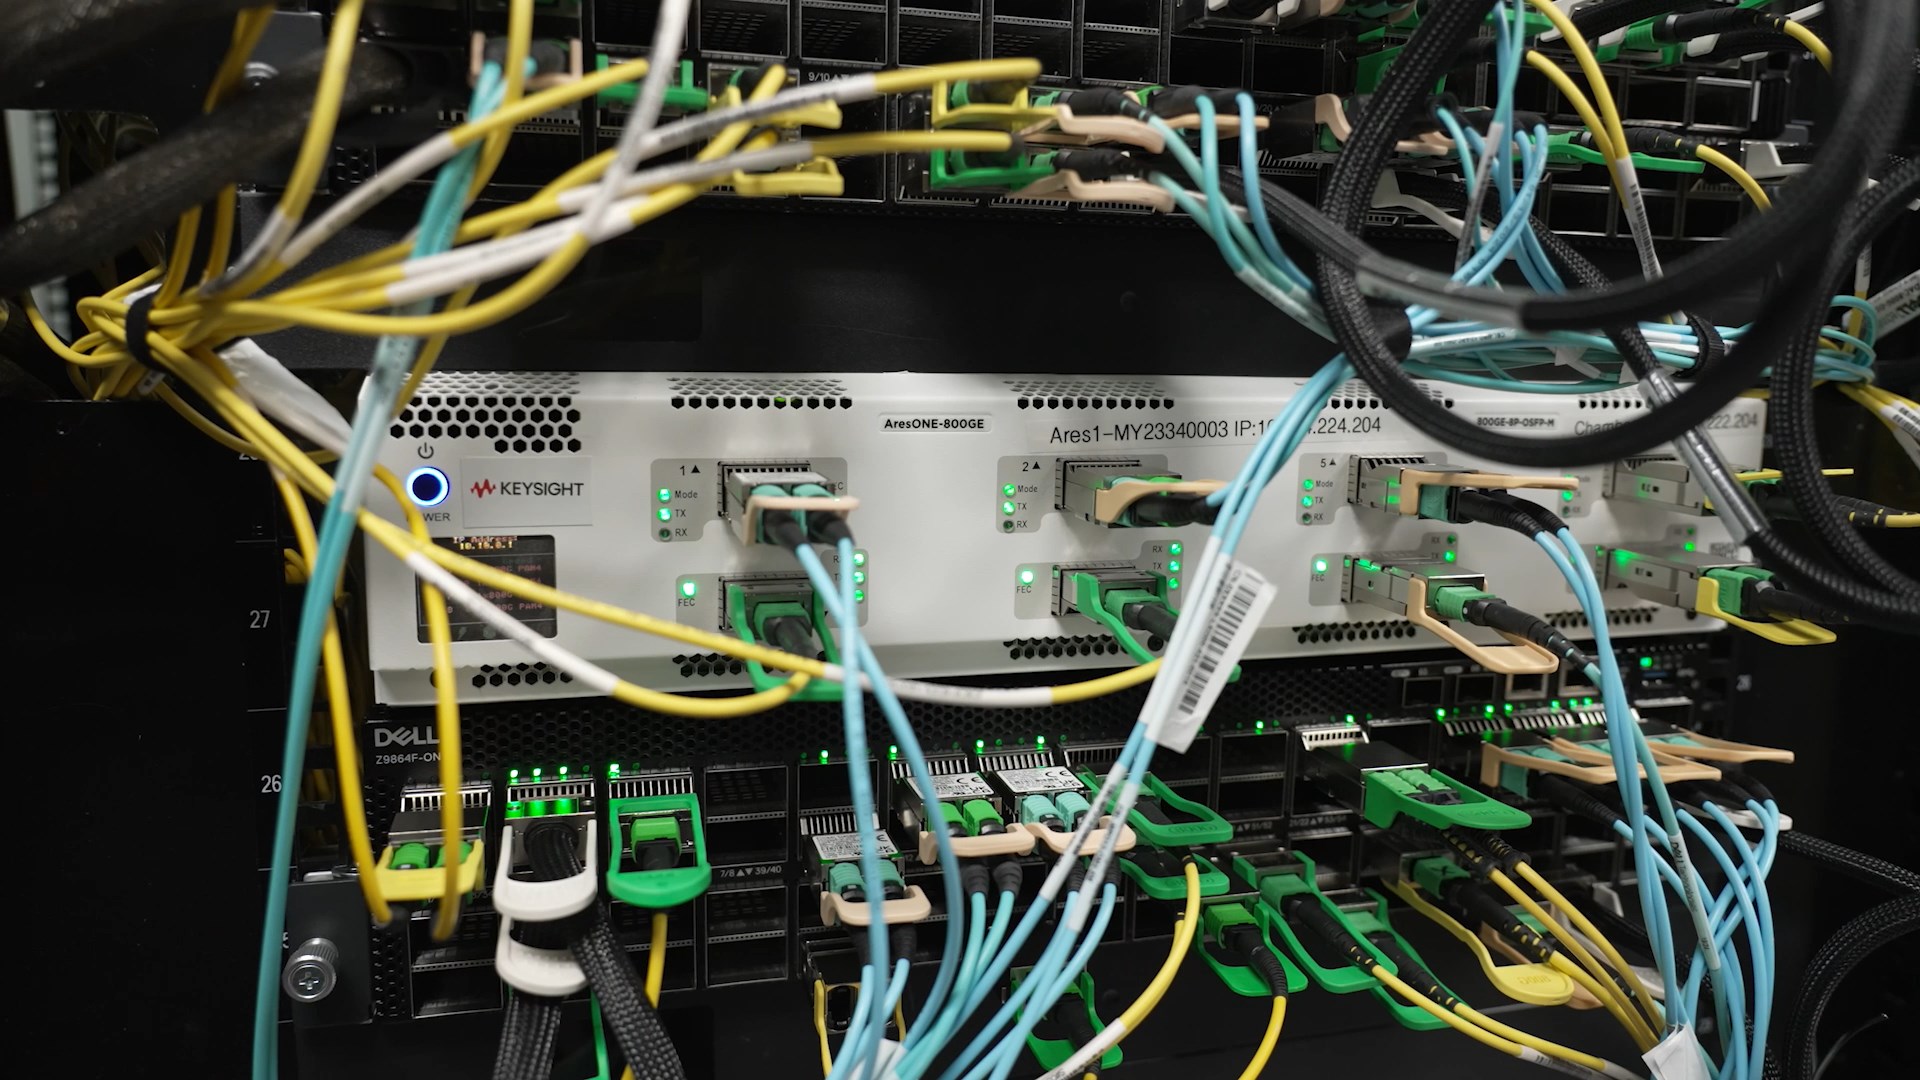
エンドツーエンドのファブリック検証
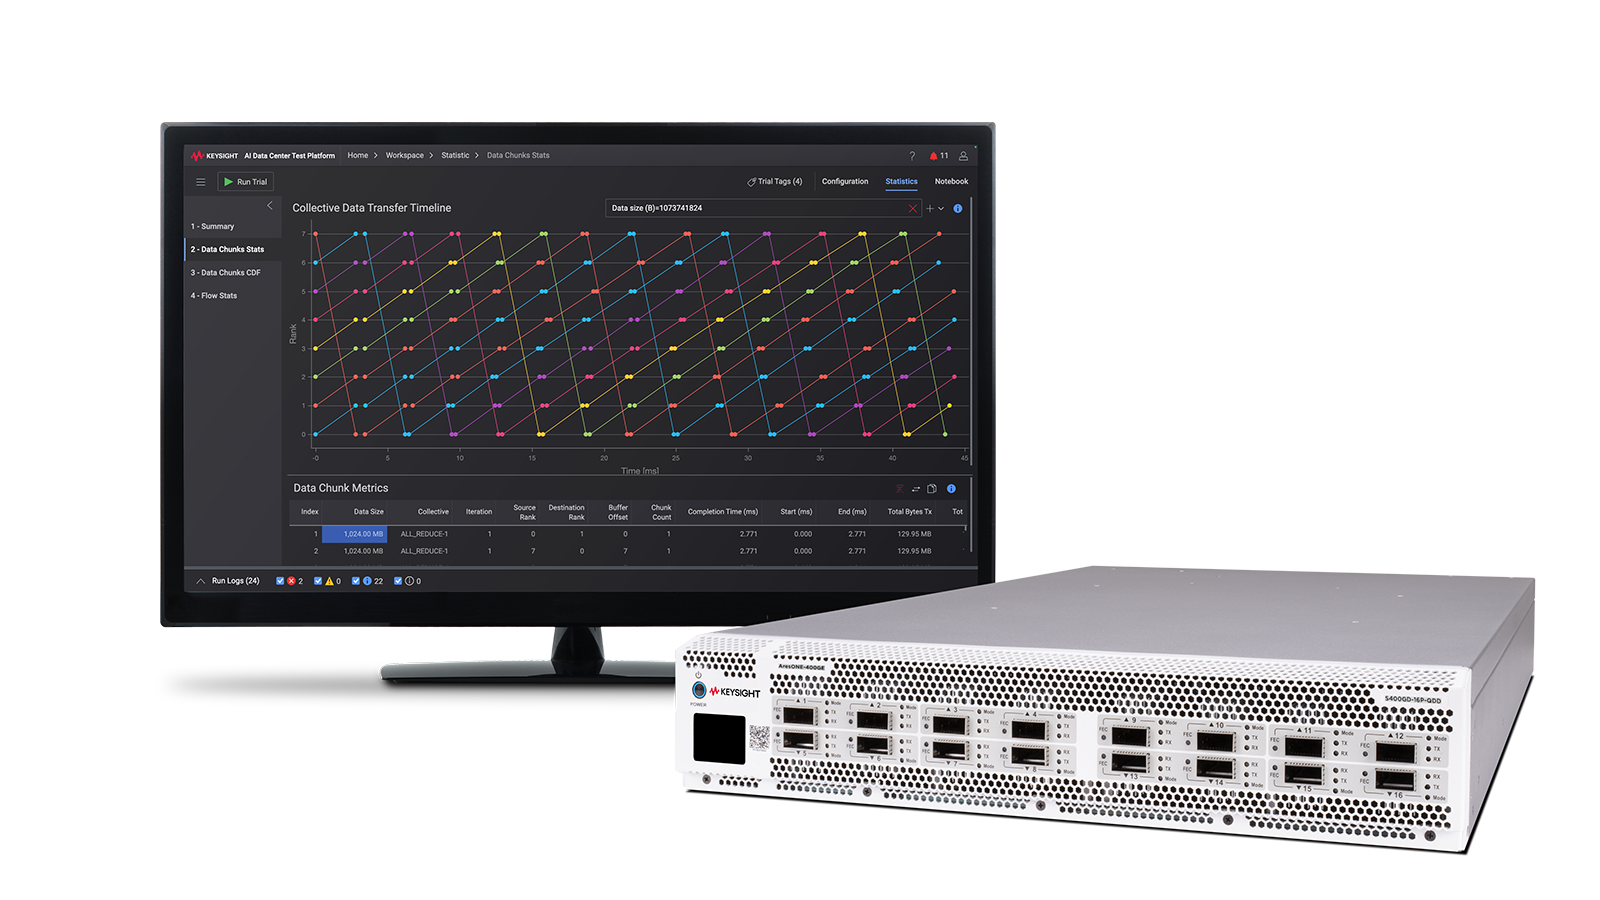
キーサイトのAI Data Center Builderを使用し、Dell、Siemon、およびキーサイトは、スイッチング、接続、およびワークロードエミュレーションを統合したエンドツーエンドのAIファブリックを構築および検証しました。Enterprise SONiCを搭載したDell PowerSwitchは、適応ルーティング、強化されたハッシュ、輻輳管理などのAI対応機能を可能にし、Siemonはロスレス伝送に必要な高性能銅線および光インフラストラクチャを提供しました。AresONEネットワークトラフィックジェネレータを搭載したキーサイトは、ステートフルRoCEv2を介したマルチGPU環境および集合操作をエミュレートし、展開前のフルシステムベンチマーク、輻輳解析、および精密なチューニングを可能にしました。

AI対応のパフォーマンス
検証済みのAI対応ネットワークファブリックは、現実的なAIワークロードの下で安定した確定的パフォーマンスを提供しました。ステートフルRoCEv2トラフィックを使用することで、ファブリックは輻輳下でもパフォーマンスを維持できました。レールトポロジー全体で完了時間はマイクロ秒以内に収まりました。このデモンストレーションは、統合されたスイッチング、接続、およびベンチマークが、展開リスクを低減し、GPU利用率を向上させ、次世代AIファブリックを1.6T以上に拡張する準備を整えることを確認しました。


関連リソースを探索

ホワイトペーパー
大規模AIネットワークの設計と検証のための7つの教訓
トラフィック動作やトポロジの選択から、ケーブル配線、光学部品、ロードバランス、800G、1.6T、およびそれ以降におけるフルシステムのエミュレーションに至るまで、AIネットワークファブリックの設計、接続、検証における重要な考慮事項を探ります。
ホワイトペーパー
実環境性能のためのAIデータセンターのスケーリング
AIインフラストラクチャ規模でのエミュレーション、検証、クラスター動作に関する技術的洞察

レポート
AIクラスターネットワーキングのボトルネック、規模、そして次に来るもの
AIデータセンターにおけるインフラ投資、エミュレーションのギャップ、相互接続の採用、最適化の優先順位に関する調査に基づく洞察
×
営業担当者からご連絡させていただきます。
*は必須項目です
ありがとうございました。
営業担当者より近日中にご連絡いたします。