何をお探しですか?
AIデータセンター
次世代のAIイノベーションを解き放つ

AIの潜在能力を最大限に引き出す
AIデータセンターの信頼性は、最も弱いリンクと同等でしかありません。パフォーマンスの最先端において、すべてのチップ、ケーブル、インターコネクト、スイッチ、サーバー、GPUは、可能性とリスクの両方を表しています。個々のコンポーネントが独立して機能するだけでなく、容赦ない要求の下でシステムとして一丸となって機能する必要があります。
AIワークロードの要求に対応できるネットワーク構築には、すべてのコンポーネント、接続、構成の検証が不可欠です。これほど重大かつ大規模な状況においては、わずかな効率の向上、運用の改善、パフォーマンスの強化であっても、大きな見返りをもたらし、中断を減らし、連鎖的な障害を防ぐことができます。
AIデータセンター:技術的な変曲点

イーサネット
データセンターの速度は、400 / 800Gから高速な1.6 / 3.2Tイーサネットへと向上します。

メモリ
DDR5からDDR6およびHBM3への移行が進んでおり、その速度は最大12.8 GT/sに達します。

光
112 Gb/sの転送速度は、224および448 Gb/sの規格へと移行しようとしています。

PCIe® / CXL
転送速度が32から128 GT/sへと向上するにつれて、PCIe® 5およびPCIe® 6はPCIe® 7へと更新されます。
AIデータセンターのテスト:マルチレイヤーの課題
AI時代における高速デジタル設計の加速
AIデータセンターには、AI対応の半導体、チップセット、および高速デジタル(HSD)設計が求められます。しかし、最先端のパフォーマンスには代償が伴います。速度や規格は常に進化しており、最新の状態を維持することは、時に1〜2世代先を見据えて考えることを意味します。高度な設計要件への適合は、デバッグにとどまりません。最新のPCIe®、DDR、およびCXL規格を満たす、あるいはそれを超えるには、設計を分析し、問題が発生する前に潜在的な問題を予測できる高度なシミュレーションツールが必要です。
1.6Tおよびその先を見据えたAIインフラストラクチャの再構築
AIデータセンターが1.6Tイーサネットの速度を採用するにつれて、ネットワーク機器メーカーはこれらをサポートする新しい光トランシーバを構築しています。しかし、高速接続には、AIネットワークの実世界の要求に対する高速検証も必要です。R&Dや量産テストの拡張は、物理層を測定する低ノイズ測定器を使用するにとどまらず、プロトコル層のイーサネットテストを採用して実世界のパフォーマンスを検証することも意味します。
AIデータセンターのパフォーマンスと効率の最適化
AIネットワークには、コンポーネントレベルの検証以上のものが求められます。物理層のテストだけでは不十分です。相互運用性、パフォーマンス、効率は、実際のネットワーク条件下でのシステムレベルでしか測定できません。AIクラスターコンポーネントの検証、効率の最適化、および容量の拡張には、フルスタックのAIワークロードエミュレーションから得られる高度な洞察が必要です。ジョブ完了時間や集合通信帯域幅などのメトリックを追跡することで、ボトルネックの検出、AIワークロード分散の最適化、および、そのままでは隠れたままになってしまうコンポーネントレベルの問題の特定が可能になります。
AIワークロードを拡張するための電力効率の最大化
AIデータセンターにおいて、エネルギー管理はパフォーマンスと同じくらい重要です。しかし、ハイエンドサーバーやラックスイッチは最高クラスのチップやインターコネクトを活用している一方で、クロストークや電磁干渉が電力管理の問題を引き起こし、最終的にAIデータセンターのスケーラビリティを阻害する可能性があります。汎用的な設計自動化および測定ツールがなければ、電力供給ネットワークをシミュレートし、電力問題の根本原因を特定し、最終的に電力効率を確保することは極めて困難です。
AIデータセンターに関する知識を高める

AIデータセンターを最適化し、スケールアップするための5つの戦略
AIは産業を変革し、イノベーションを推進しています。しかし、独自のトラフィックパターン、動的なワークロード、そして絶え間ない性能への圧力は、わずかな問題でさえも重大な問題へとエスカレートさせる可能性があります。
このeBookを読んで、最新のアプリケーション向けにAIデータセンターのパフォーマンスを最適化するための5つの実用的なソリューションを発見してください。


AIネットワーキングブートキャンプ
キーサイトのエンジニアと共に、AIネットワークのテストとAIデータセンターの展開の検証の世界を深く掘り下げましょう。このコースの終わりまでに、この急速に変化する革新的な新しいネットワーキングパラダイムを制御するために必要な洞察と自信を得ることができます。

AIデータセンタークラスターにおけるスケーラビリティの向上
ネットワークインフラストラクチャは、複雑でトラフィックの多いAIトレーニングワークロードを処理できるように拡張できるでしょうか?このホワイトペーパーでは、AIデータセンタークラスターのスケーリングを掘り下げ、重要なネットワークの課題を特定し、組織のAIの野望に向けてスケーラブルで信頼性の高いネットワークを確保する方法を説明します。

コレクティブオペレーションのベンチマーク
AIクラスター内のネットワークパフォーマンスの測定やベンチマークは、追加のハードウェアコストなしで全体のスループットを最適化および改善する機会を組織が特定するのに役立ちます。このホワイトペーパーでは、AIコレクティブの動作を説明し、用語を定義し、AIネットワークのベンチマークに関連する最も一般的なメトリックを確認します。
キーサイトがAIデータセンターをどのように支援するか
弱いリンクを排除する
物理層テストとシステムレベルのネットワークエミュレーションにより、コンポーネントレベルのパフォーマンスを確保します。
すべてのレイヤーを最適化する
データセンター設計をモデリングし、AIスケールでネットワーク機器を検証し、システムレベルのパフォーマンスを微調整します。
AI容量の拡張
現実的なプロトコル、アプリケーション、ネットワークのエミュレーションにより、データセンターのパフォーマンスを最大化します。
最新のAIデータセンターソリューションを見る

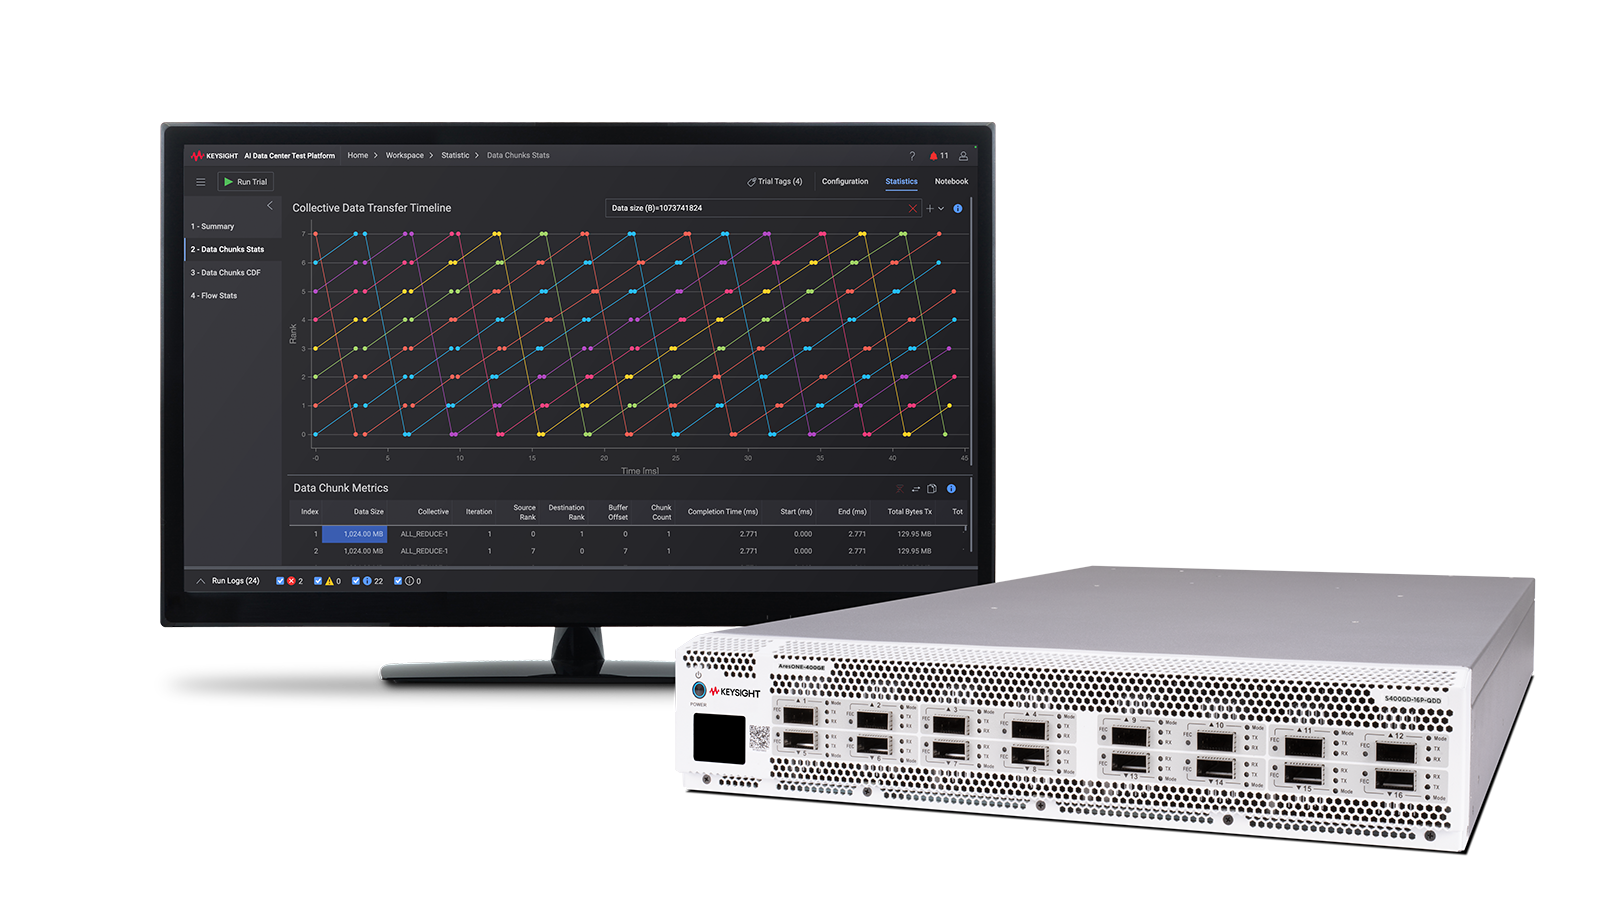
KAI Data Center BuilderでAIインフラストラクチャを最適化
比類のない忠実度でAIデータセンターのパフォーマンスをベンチマークします。KAI Data Center Builderは、大規模学習モデル(LLM)の構築に使用される集合通信とアルゴリズムの組み合わせをエミュレートし、システム全体のテストを通じてネットワークインフラストラクチャとAIファブリックを簡単に検証できるようにします。

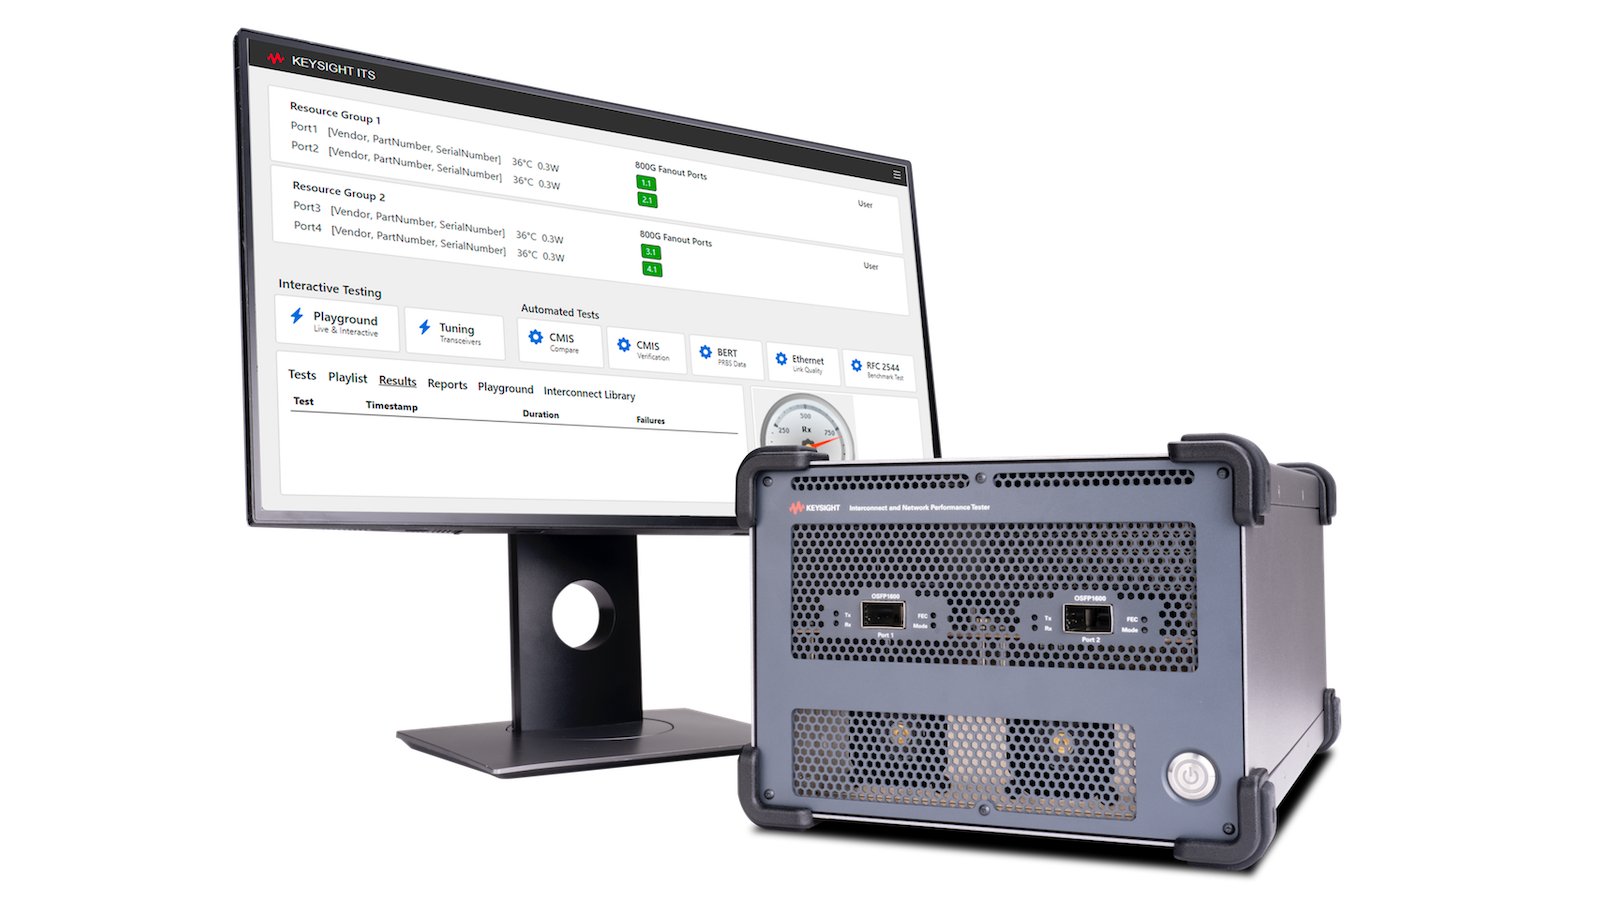
高速ベンチトップテスターでイーサネットの信頼性を最大化
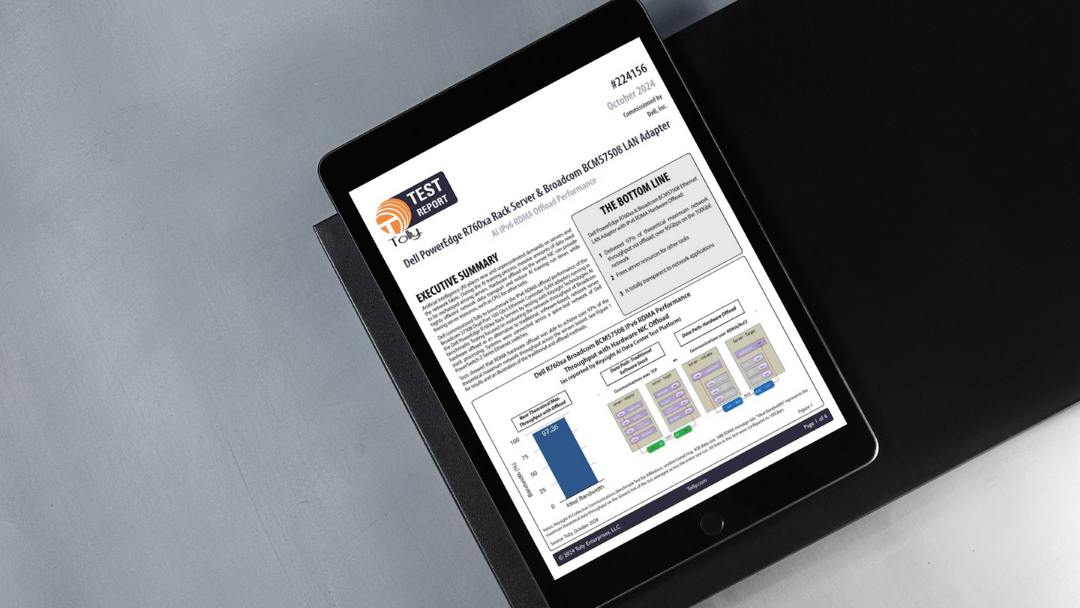
最新世代のAI最適化ネットワークおよびインターコネクトをテストします。レイヤー1~3の完全なテストカバレッジと、ポートあたり最大40Wのサポートを備えたKeysight Interconnect and Network Performance Tester 1.6Tは、スイッチメーカーやハイパースケーラーに最先端のイーサネットテスト機能を提供します。

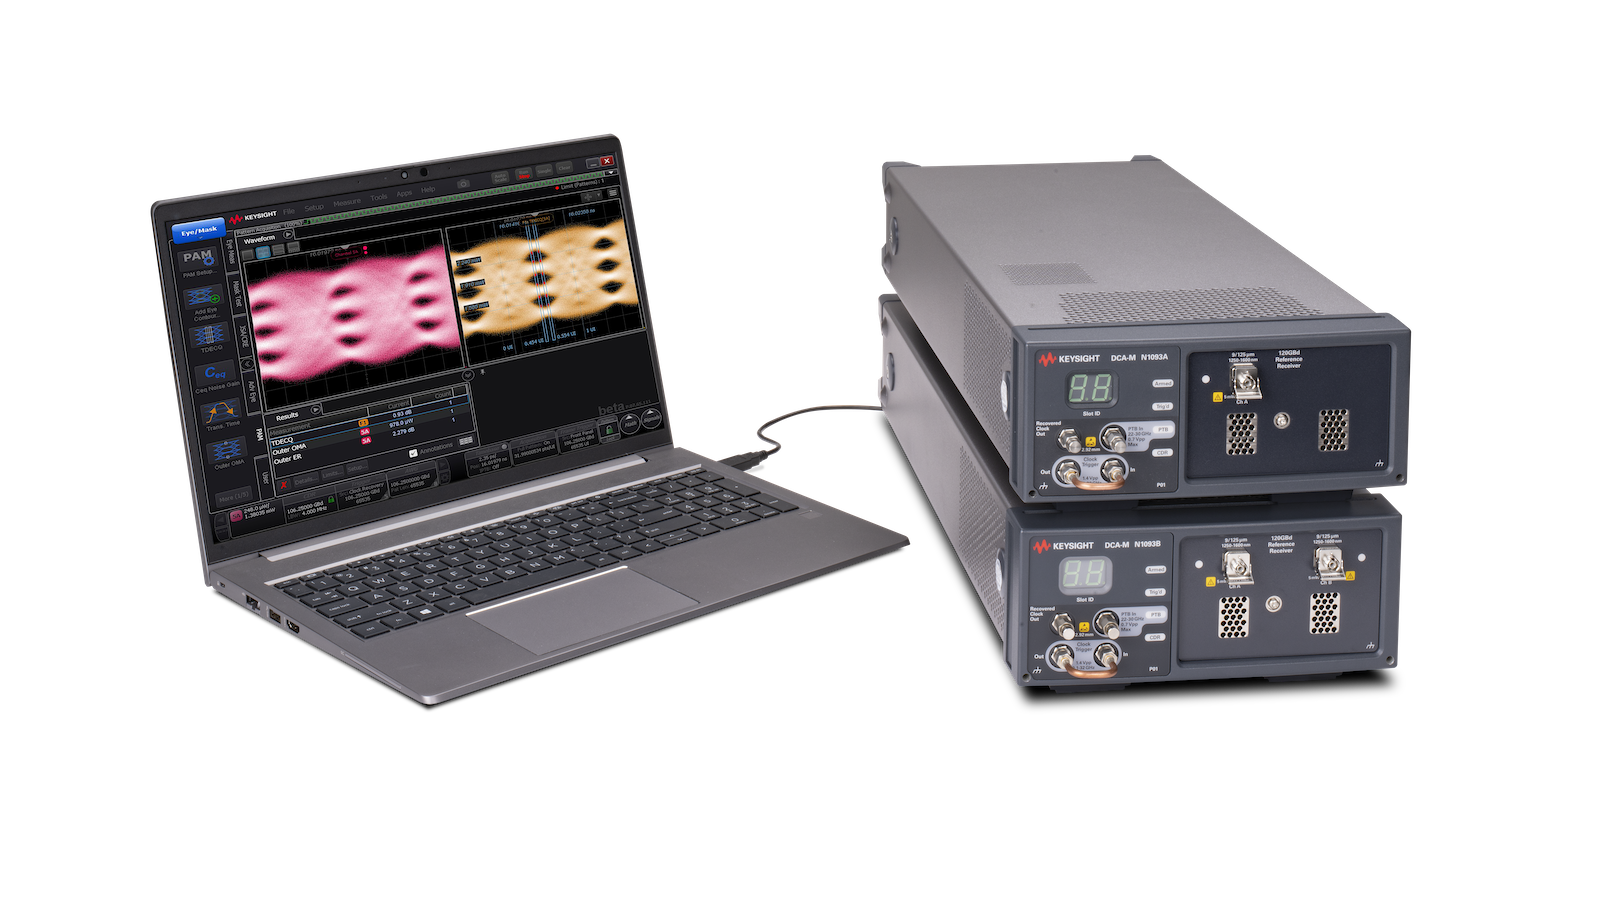
DCA-MサンプリングオシロスコープによるAIインターコネクトの検証
比類のない光学的精度とトランシーバテスト効率を提供する224 Gb/sサンプリングオシロスコープでネットワークの信頼性を最大化します。大量生産される光トランシーバの製造テストを効率化する光テストソフトウェアを使用して、AI対応の800G / 1.6Tネットワーク機器をテストします。
AIショーケースイベントに参加する
高価なGPUリソースを消費することなく、AIデータセンターを設計、検証、スケールする方法を学びましょう。物理層からアプリケーション層まで機能するツールを活用してパフォーマンスを最大化する新しい方法を発見してください。AIイノベーションの最前線で活躍するトップクラスのキーサイトのエンジニアによるライブQ&Aにも参加できます。

AI対応テストセットアップを見る


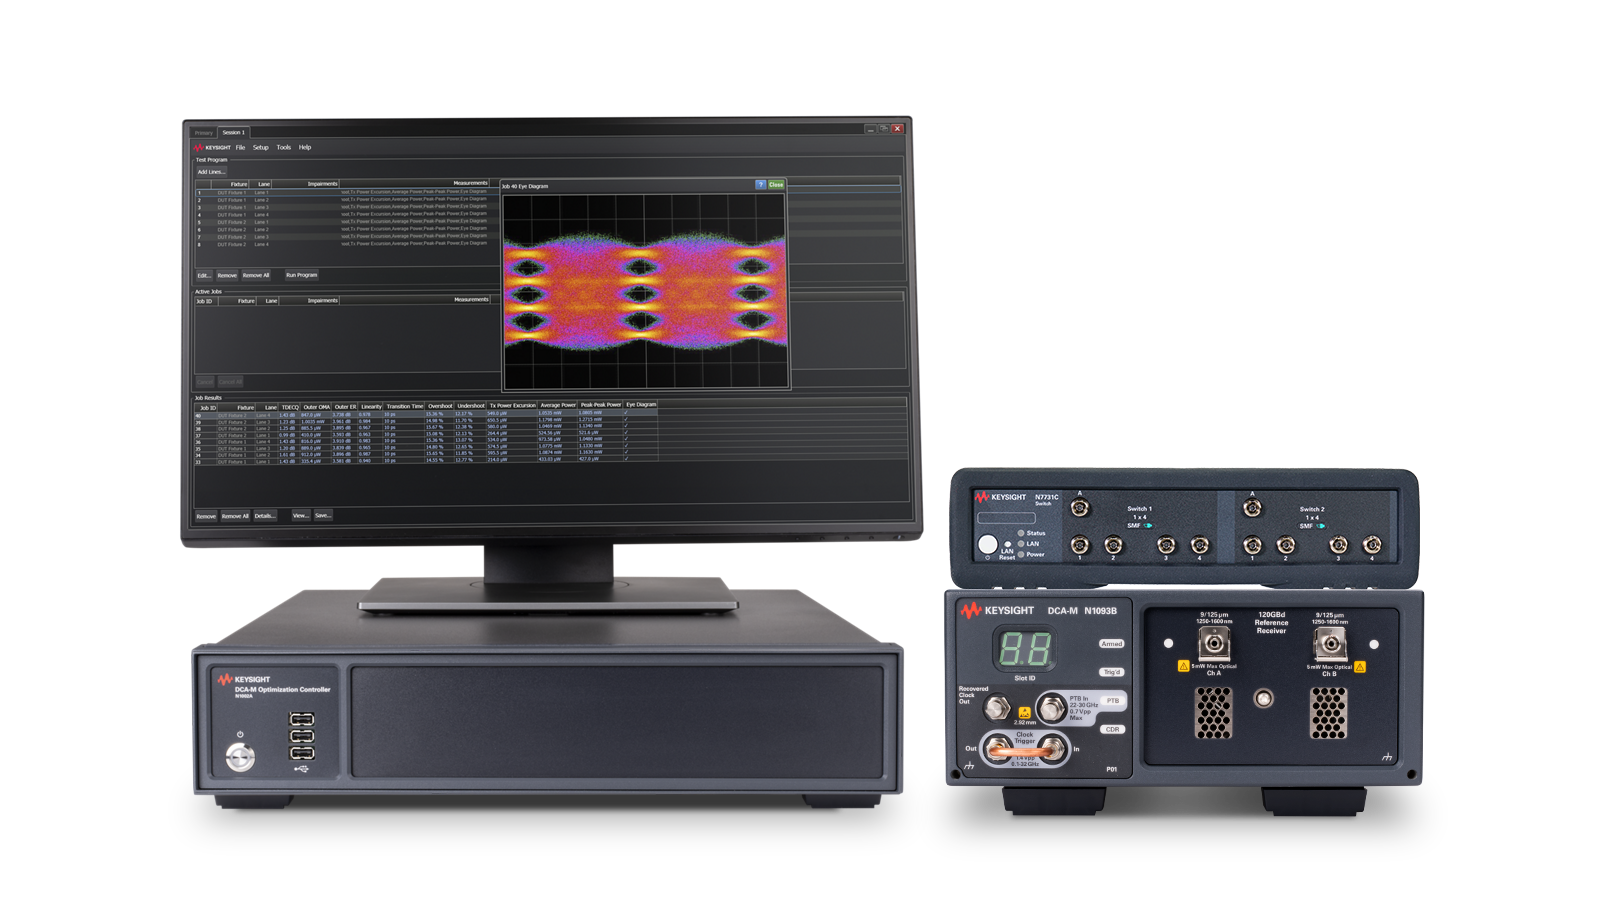

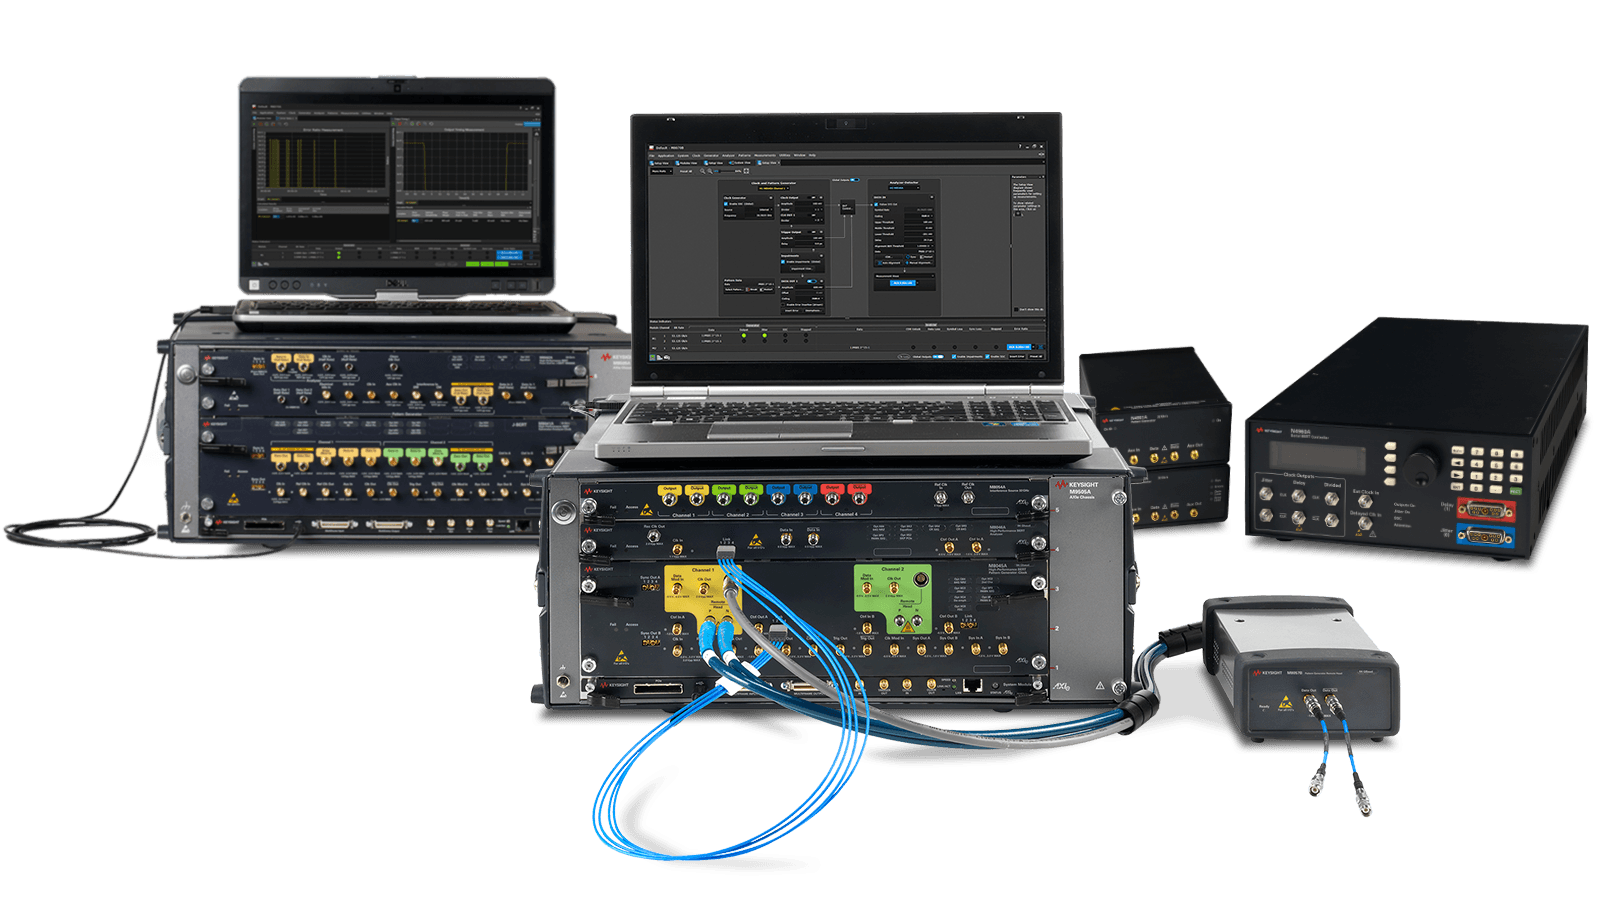
PAM4レシーバー信号の解析
PAM4レシーバー受信信号を理解するために、エラー解析を使用する。

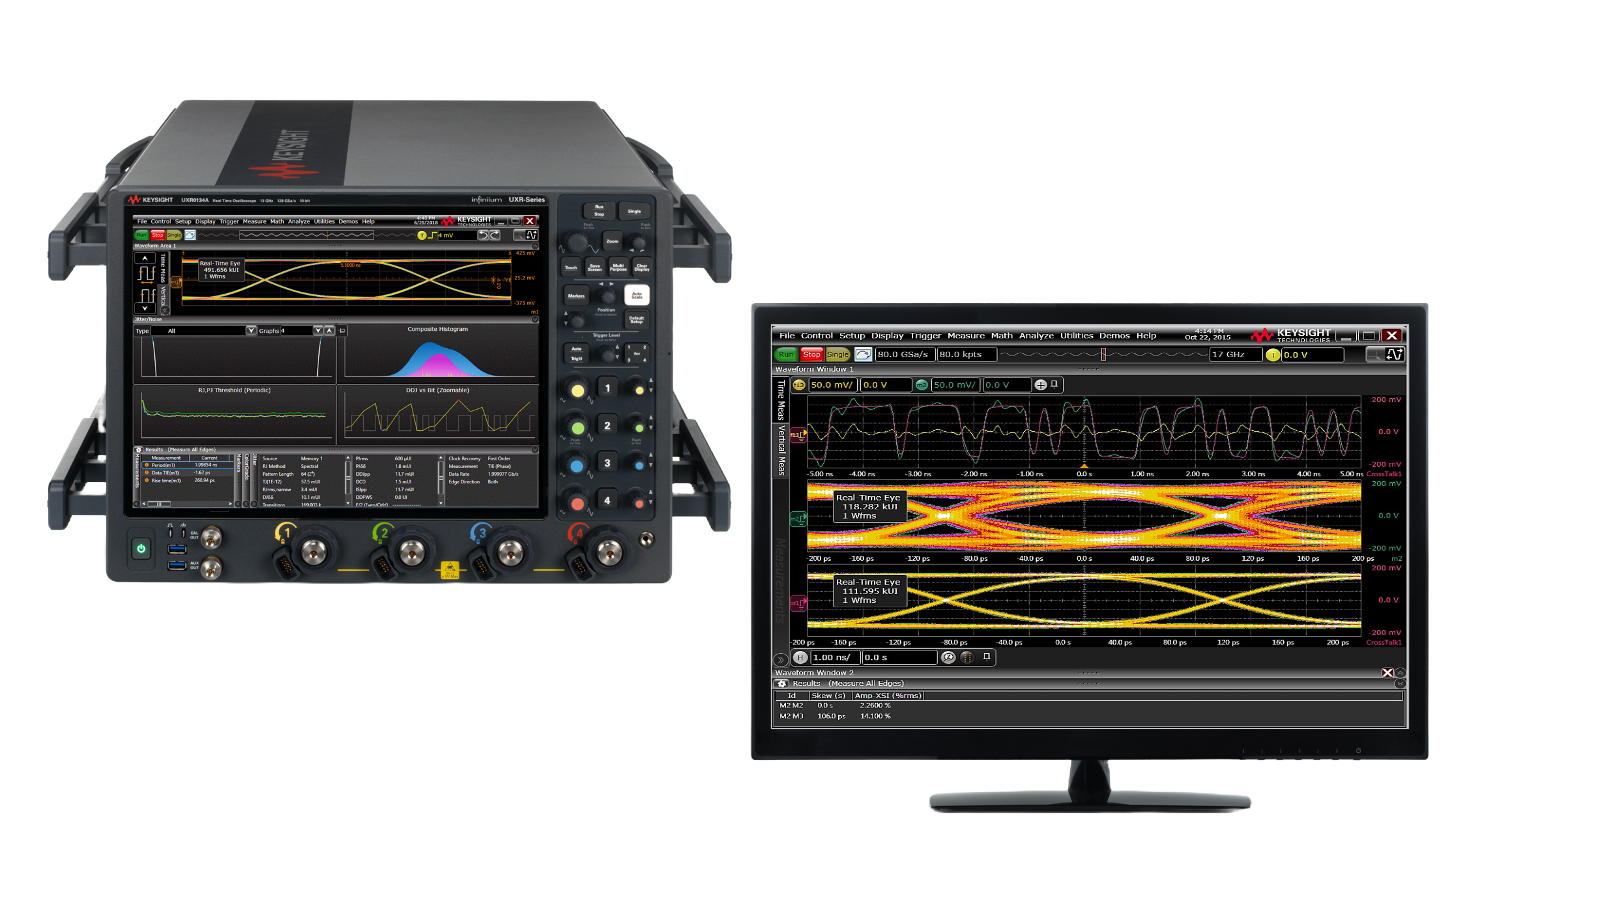
PCBシグナルインテグリティの解析
クロストーク、ジッタ、振幅ノイズ、位相ノイズの検出と診断により、高速デジタル PCBにおけるシグナルインテグリティのリスクを低減します。

PCIe® 6.0プロトコル検証を実行します。
物理層、データリンク層、トランザクション層でプロトコル評価を達成する。

FEC性能を評価します。
エラー訂正メカニズムを評価することにより、高速イーサネットリンクをテストする。
AIデータセンターのテストに関する詳細はこちら









よくある質問:AIデータセンター
AIデータセンターは、人工知能(AI)アプリケーションをサポートするために専用に構築された特殊なコンピューティング施設です。AIデータセンターは、GPU(グラフィックス処理ユニット)やTPU(テンソル処理ユニット)などの強力なツールを活用し、大容量のトラフィック処理、大規模言語モデル(LLM)のトレーニング、ユーザーからのクエリの実行(一般に「推論」と呼ばれるプロセス)を可能にします。
高まる需要を満たすために、AIデータセンターは世界中で建設されています。しかし、その大部分は米国、特にテキサス州、カリフォルニア州、バージニア州に位置しています。
AI対応データセンターには、いくつかの特徴的な点があります。
- ハードウェア:AIコンピュートを加速する高性能GPUおよびTPU。
- ストレージ:AIのトレーニングと推論に必要な膨大なデータを管理する、高速かつ大容量のストレージシステム。
- 冷却:AIインフラストラクチャは多量の熱を発生するため、AI対応データセンターでは、過熱を防ぐために液冷や精密空調などの高度な冷却技術が必要となります。
- スケーリング:AIデータセンターは、AIタスクの変動する要求に基づいて、リソースを効率的に拡張する必要があります。
- ネットワーク:リアルタイムのデータ処理と通信には、高帯域幅かつ低遅延の接続が不可欠です。
- セキュリティ:堅牢なセキュリティ対策と信頼性の高いインフラストラクチャにより、多様なAI特有のサイバー攻撃に対する保護と可用性が確保されます。
従来のデータセンターが幅広い汎用コンピューティングタスクを処理するのに対し、AIデータセンターは、大容量データの処理、大規模学習モデルのトレーニング、およびユーザーからのクエリに対する推論に最適化されています。従来のデータセンターは汎用コンピューティングタスクにCPUを使用し、ストレージ、サーバー、クラウド環境間でのデータ転送に標準的なネットワークアーキテクチャを使用します。一方、AIデータセンターは、プロセッサ間の高速なデータ移動を処理するために、GPU、TPU、および高速・低遅延ネットワーキングに依存しています。
AIデータセンターはさまざまなワークロードを処理します。それぞれ、コンピューティングとストレージに対する独自の要件があります。最も一般的なワークロードのいくつかには、以下のようなものがあります。
- データ処理ワークロード
- 機械学習ワークロード
- ディープラーニング(深層学習)ワークロード
- 自然言語処理(NLP)ワークロード
- 生成AIワークロード
- コンピュータビジョンワークロード
AIデータセンターでは、効率的なデータ管理のために複数の戦略が活用されています。これには、高速なデータアクセスと取得を保証するNVMe SSDなどの高性能ストレージシステム、使用パターンに基づいて異なるストレージ階層間でデータを移動するデータタイアリング、およびストレージ容量を節約して効率を向上させるデータ圧縮・重複排除技術などが含まれます。
AI最適化データセンターでは、トレーニングと推論を加速するために特殊なハードウェアを採用しています。以下に、最も一般的なコンポーネントの一部を示します。
- グラフィックス処理ユニット(GPU):AIアプリケーションで一般的に必要とされる並列処理タスクに不可欠な機器です。
- テンソル処理ユニット(TPU):機械学習タスク向けに設計されており、AIモデル向けに高性能なトレーニングと推論を提供します。
- AI最適化ストレージ:NVMe SSDなどの高性能ストレージソリューションは、効率的なデータ取得により大規模なデータセットの管理を支援します。
- ネットワークインフラストラクチャ:Infiniband、イーサネット、NVIDIA Spectrum-Xは、高速通信を提供し、ボトルネックを削減し、スループットを向上させます。
- 冷却システム:液冷などの高度な冷却技術により、ネットワーク機器およびインフラストラクチャ全体の熱効率の管理が支援されます。
GPUとTPUは、AIワークロードの集中的な計算需要を効率的に処理することで、AIデータセンターのパフォーマンスを加速させます。これらがもたらす主なメリットをいくつか紹介します。
- トレーニング時間の短縮:GPUとTPUはAIモデルのトレーニング時間を短縮し、AIアプリケーションの迅速かつ効率的な開発・デプロイを容易にします。
- エネルギー効率:GPUとTPUはエネルギー効率が高く、ハイパースケーラーが運用コストと環境への影響を管理するのに役立ちます。
- 機能の強化:GPUやTPUにより、AIデータセンターはより複雑で高度なAIモデルをサポートできるようになり、さまざまな産業でイノベーションが推進されます。
AIのコンピュートサイクルでは膨大な熱が発生します。そのため、AIデータセンターでは熱を管理・相殺するための高度な冷却ソリューションが求められます。AIデータセンターで採用されている主な冷却技術には、以下のようなものがあります。
- 液冷(水冷):GPUやTPUなどの発熱源に冷却液を直接循環させます。
- 液浸冷却:ITコンポーネントを誘電性液体に浸すことで、空気よりも効果的に熱を吸収します。
- リアドア型熱交換器:サーバーラックの背面に取り付ける冷却システムで、液冷を使用してラックの排気から直接熱を取り除きます。
AIデータセンターでは通常、スケーラビリティを確保するために複数の戦略を採用しています。
- モジュール性:AIデータセンターでは、需要の増加に応じて拡張可能なモジュール型コンポーネントを使用し、大きなダウンタイムを伴わずに段階的なスケーリングを実現します。
- 冷却:パフォーマンスと信頼性を維持するためには、効率的な冷却がAIデータセンターに不可欠です。液冷やAI駆動型管理は、エネルギー使用の最適化と追加のスケーリングのサポートに役立ちます。
- AI管理:AIを活用することで、ワークロードの予測と管理、リソースの最適化、データセンターの効率化が可能になります。このプロactiveなアプローチにより、ハイパースケーラーは変動する需要に合わせて拡張し、最適なパフォーマンスを維持することができます。
エッジコンピューティングは、AIデータセンターにおけるパフォーマンスの向上、レイテンシの削減、リソース使用の最適化に貢献します。推論処理を発生源の近くで行うことでリアルタイムのデータ処理が可能になり、データが移動する距離が最小限に抑えられるため、帯域幅の最適化と全体的なレイテンシの削減につながります。
ハイパースケーラーは、AIデータセンターにおける効率的なエネルギー消費を確保するために、いくつかの革新的な戦略を採用しています。
- 再生可能エネルギー:ハイパースケーラーは、太陽光や風力などの再生可能エネルギー源の活用をますます進めています。これらの持続可能なエネルギー源により、二酸化炭素排出量を削減し、持続可能なエネルギー供給を確保します。
- 冷却:AIデータセンターのエネルギー消費量を削減するには、熱管理が極めて重要です。そのため、ハイパースケーラーは効率的なエネルギー使用を確保すべく、液冷やAI駆動型の冷却管理に投資しています。
- インフラストラクチャ:AIデータセンターのレイアウトと設計は、エネルギー消費と効率において重要な役割を果たします。ホットアイルおよびコールドアイルの封じ込め、理想的なサーバー配置、適切な気流といった戦略はいずれもエネルギー効率の向上に貢献します。
AIデータセンターには、特定の脆弱性から保護するための専門的なセキュリティアプローチが求められます。たとえば、大規模学習モデルは、プロンプトインジェクションや敵対的攻撃(悪意のある入力によってAIモデルが欺かれる可能性がある攻撃)に対して特に脆弱です。そのため、アプリケーションおよびセキュリティテストツールを用いた継続的なテスト、多要素認証やロールベースアクセス制御を含むアクセス制御、定期的なセキュリティ監査といったセキュリティ戦略が極めて重要となります。
AIデータセンターは、ディープラーニングや機械学習の厳しい要件をサポートするために専用設計されています。
- GPU、TPU、AIアクセラレータなどの高性能ネットワークハードウェアが、機械学習およびディープラーニングのモデルトレーニングに関わる複雑な計算処理を処理します。
- 高帯域幅インターコネクトにより、ストレージとコンピュートノードの間で効率的かつ高速なデータ交換が確保されます。
- 拡張性の高いインフラストラクチャにより、計算能力とストレージに対する増大する需要に対応します。これは、複雑なAIモデルや肥大化するデータセットにとって不可欠です。
世界中でAIデータセンターを構築・維持しているハイパースケーラーやAIプロバイダーは多数存在します。最大手のプロバイダーには、Amazon Web Services、Google、OpenAI、Apple、Metaなどが挙げられます。
サポートが必要ですか、ご質問がありますか?