Wie man KI-Inferenz vor dem Einsatz validiert

Validierung der Inferenzinfrastruktur vor der Hardwarebereitstellung
Richten Sie eine Validierungsumgebung für KI-Inferenz vor der Bereitstellung ein, indem Sie die geplante Rechenzentrumstopologie in einem digitalen Zwilling modellieren. Bilden Sie Switching- und Routingpfade, Inferenzdienste, Sicherheitskontrollen und die vorgesehenen Verbindungen zwischen Client-Eingang und Inferenz-Backends ab. Konfigurieren Sie die Emulation von KI-Inferenz-Workloads, um realistische Eingabeaufforderungen und Antworten für große Sprachmodelle zu generieren, einschließlich unterschiedlicher Eingabeaufforderungslängen, Antwortmuster und gleichzeitiger Benutzer. Definieren Sie ein reproduzierbares Workload-Profil, legen Sie die Ankunftsraten von Anfragen fest und wählen Sie repräsentative Testdauern, bevor Sie die modellierte Architektur testen. Erfassen Sie die End-to-End-Antwortlatenz, die Zeit bis zum ersten Token, die Token-Ausgaberate und die Ergebnisse der Anfrageabwicklung auf jeder Workload-Ebene. Korrelieren Sie diese inferenznativen Beobachtungen, sofern verfügbar, mit Infrastrukturtelemetriedaten aus den Bereichen Rechenleistung, Netzwerk und Sicherheit. Verwenden Sie identische Workload-Eingaben für alle Architekturvarianten, damit beobachtete Unterschiede der simulierten Systemkonfiguration und nicht dem geänderten Eingabeaufforderungsverhalten zugeschrieben werden können.
Führen Sie zunächst eine Basislinie mit geringer Anzahl gleichzeitiger Nutzer durch und erhöhen Sie anschließend die simulierte Nachfrage kontrolliert, wobei die Lastverteilung beibehalten wird. Verfolgen Sie Änderungen im Token-Durchsatz, der Latenz der letzten Antwort, den Abschlussraten und dem Verhältnis zwischen angebotener Last und bereitgestellter Inferenzkapazität. Vergleichen Sie verschiedene Routing-, Sicherheits- und Inferenzdienstkonfigurationen innerhalb derselben modellierten Umgebung und erfassen Sie die Konfigurationsdetails für jeden Durchlauf. Untersuchen Sie, wie sich lange Kontext- und Mehrrundensitzungen auf die Nachfrage im modellierten Inferenzpfad auswirken und ab welchem Punkt sich die Antwortzeitverteilung verbreitert. Sobald die Integration Systemtelemetriedaten verfügbar macht, vergleichen Sie die Inferenzmessungen mit dem gemeldeten Verhalten von Grafikprozessor, Speicher und Netzwerk. Trennen Sie Beobachtungen des digitalen Zwillings von Ergebnissen, die eine Validierung auf physischer Hardware erfordern. Dokumentieren Sie die getesteten Annahmen zur Arbeitslast, die Software- und Netzwerkkonfigurationen, die Messdefinitionen und die beobachteten Grenzwerte für jeden Kandidaten. Diese Ergebnisse bilden einen reproduzierbaren Validierungsnachweis vor der Bereitstellung und stellen keine Aussage über die garantierte Produktionsleistung dar.

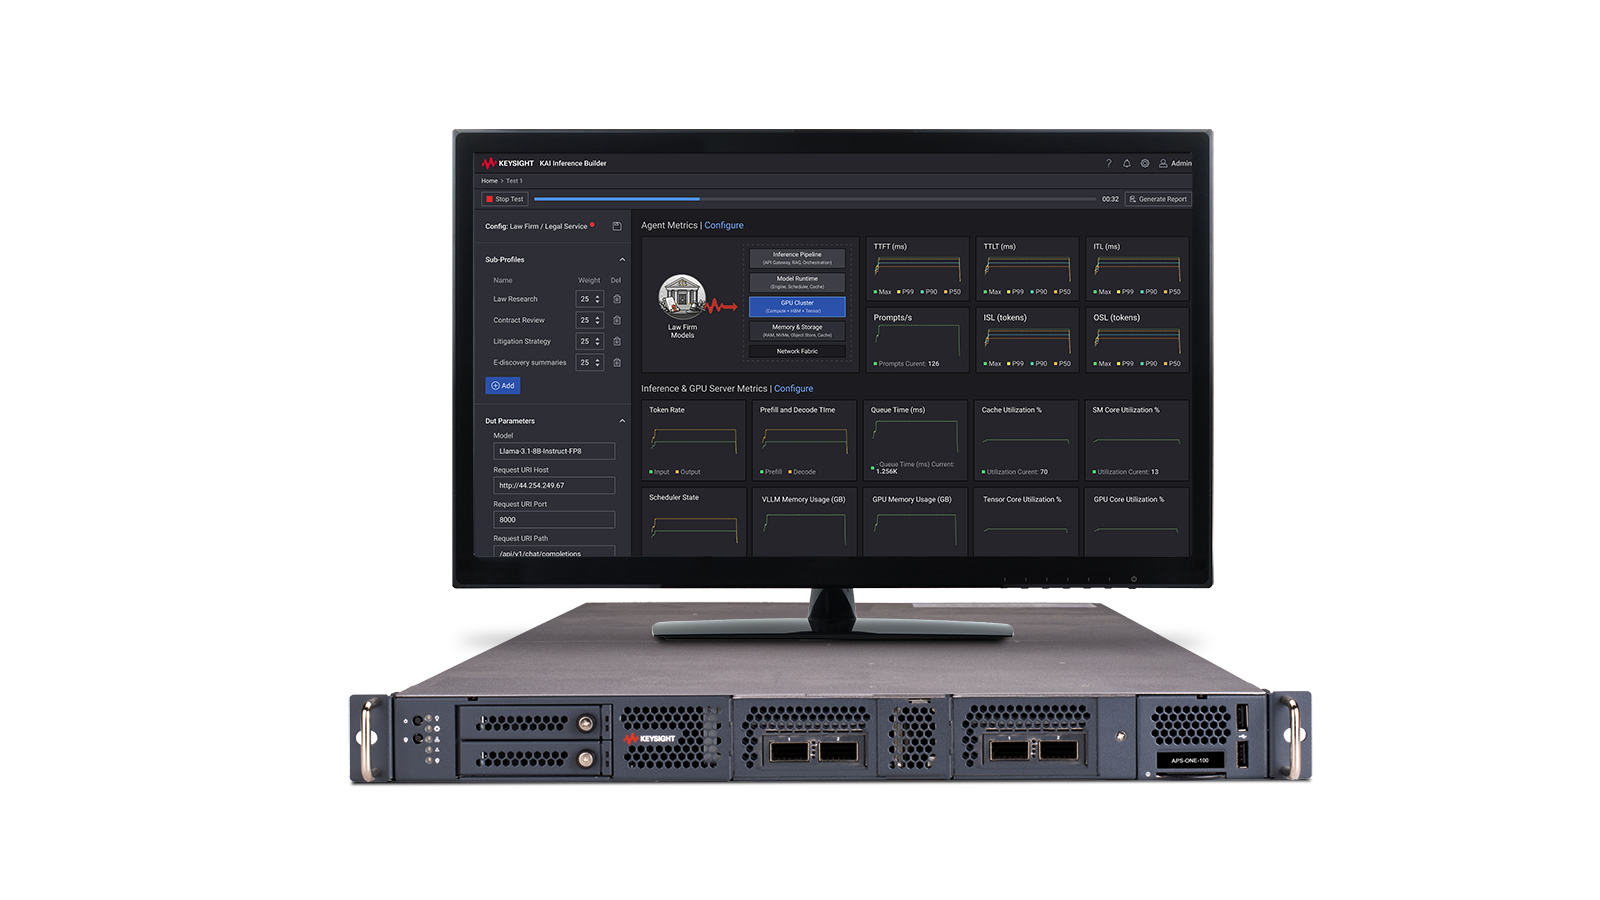
KI-Inferenzvalidierungslösung vor der Bereitstellung
Demo-Video der Lösung zur Validierung von KI-Inferenz vor der Bereitstellung ansehen
Entdecken Sie Produkte in unserer Lösung zur Validierung von KI-Inferenz vor der Implementierung.
-

![]()
952-1001 KAI Inference Builder Bundle mit 2 Agenten und bis zu 100 Eingabeaufforderungen pro Sekunde


Entdecken Sie Ressourcen und Einblicke
Zusätzliche Ressourcen für die Validierung von KI-Inferenz vor der Bereitstellung
Verwandte Anwendungsfälle

-
![]()
Mehr erfahren
Wie man testet 1.6T Optische Empfängerempfindlichkeit
Führen Sie automatisierte Empfindlichkeitstests für optische Empfänger unter Belastung für 800GBASE und 1,6TBASE durch, indem Sie Muster- und Interferenzgenerierung, optische Stresskonditionierung, Kalibrierung, Modulsteuerung und BER-Erkennung pro Lane unter der Kontrolle der optischen Empfängertestsoftware integrieren.
Mehr erfahren

-
![]()
Mehr erfahren
Wie man die Leistung von elektrischen Evaluierungsboards validiert
Validieren Sie eine elektrische Evaluierungsplatine, indem Sie PRBSQ-Muster durch aktive oder passive Testbauelemente leiten, Rückkopplungen durch das Bauelement oder die Platine routen und die Bitfehlerrate und das Vorwärtsfehlerkorrekturverhalten spurweise über die konfigurierten Hochgeschwindigkeits-PAM4-Spuren messen.
Mehr erfahren
-
![]()
Mehr erfahren
Wie man validiert 1.6T Optische Transceiver
Benchmark ein vollständig neu getaktetes 1.6T Optische Transceiver über Host-seitige und optische Loopback-Pfade verbinden, unterstützte Ethernet-Modi über CMIS konfigurieren und BER- und FEC-Statistiken pro Lane während kurz- oder lang andauernder Systemleistungstests messen.
Mehr erfahren

Kontaktieren Sie einen unserer Experten
Benötigen Sie Hilfe bei der Suche nach der richtigen Lösung für Sie?