Come verificare la correttezza dell'inferenza dell'IA prima della distribuzione

Verifica dell'infrastruttura di inferenza prima dell'implementazione hardware
Configurare un ambiente di validazione dell’inferenza AI pre-implementazione modellando la topologia prevista del data center in un gemello digitale. Rappresentare i percorsi di commutazione e instradamento, i servizi di inferenza, i controlli di sicurezza e le connessioni previste tra l’ingresso dei client e i backend di inferenza. Configurare l’emulazione del carico di lavoro di inferenza dell’intelligenza artificiale per generare prompt e risposte realistici per modelli linguistici di grandi dimensioni, incluse lunghezze variabili dei prompt, modelli di turni e utenti simultanei. Definire un profilo di carico di lavoro riproducibile, specificare le frequenze di arrivo delle richieste e scegliere durate di test rappresentative prima di testare l’architettura modellata. Registrare la latenza di risposta end-to-end, il tempo fino al primo token, la frequenza di output dei token e gli esiti di completamento delle richieste a ciascun livello di carico di lavoro. Ove disponibile, correlare tali osservazioni native dell’inferenza con la telemetria dell’infrastruttura proveniente dai livelli di elaborazione, rete e sicurezza. Utilizzare input di carico di lavoro identici in tutte le varianti dell’architettura, in modo che le differenze osservate possano essere attribuite alla configurazione simulata del sistema piuttosto che a un cambiamento nel comportamento dei prompt.
Eseguire un test di riferimento con un basso numero di utenti simultanei, quindi aumentare la domanda emulata in fasi controllate, mantenendo invariata la distribuzione del carico di lavoro. Monitorare le variazioni nel throughput dei token, nella latenza di risposta di coda, nei tassi di completamento e nella relazione tra il carico offerto e la capacità di inferenza fornita. Confrontare le configurazioni candidate relative a routing, sicurezza e servizi di inferenza all’interno dello stesso ambiente modellato; acquisire i dettagli di configurazione per ogni esecuzione. Esaminare in che modo le sessioni a contesto esteso e a più turni modificano la domanda sul percorso di inferenza modellato e dove la distribuzione dei tempi di risposta inizia ad ampliarsi. Quando l’integrazione rende disponibile la telemetria a livello di sistema, confrontare le misurazioni di inferenza con il comportamento riportato dell’unità di elaborazione grafica, della memoria e della rete. Separare le osservazioni provenienti dal gemello digitale dai risultati che richiederebbero una validazione dell’hardware fisico. Documentare le ipotesi relative al carico di lavoro testato, le configurazioni software e di rete, le definizioni delle misurazioni e i limiti osservati per ciascuna opzione. Questi risultati costituiscono un registro di validazione ripetibile pre-implementazione, piuttosto che una dichiarazione relativa a prestazioni di produzione garantite.

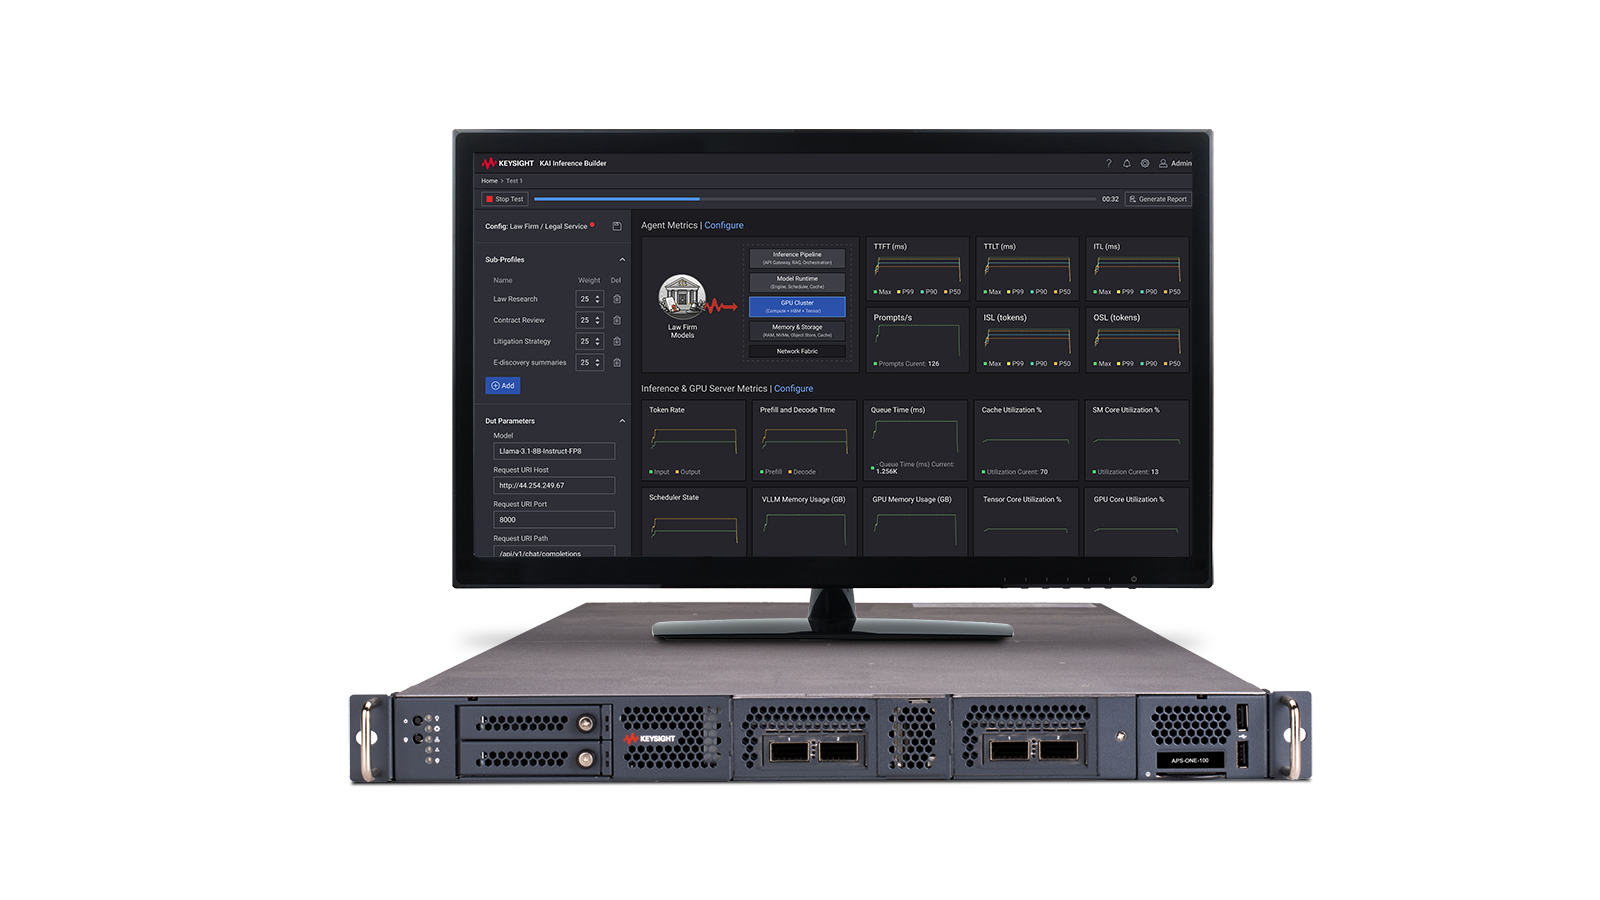
Soluzione per la convalida dell'inferenza dell'IA prima dell'implementazione
Guarda il video dimostrativo della soluzione di convalida dell’inferenza AI prima dell’implementazione
Scopri i prodotti della nostra soluzione di convalida dell'inferenza AI pre-implementazione
-

![]()
Pacchetto KAI Inference Builder 952-1001 con 2 agenti e fino a 100 richieste al secondo


Scoprire risorse e approfondimenti
Risorse aggiuntive per la convalida dell'inferenza AI prima della messa in produzione
Casi d'uso correlati

-
![]()
Per saperne di più
Come testare la sensibilità del ricevitore ottico da 1,6 T
Eseguire test automatizzati di sensibilità dei ricevitori ottici sotto stress per gli standard 800GBASE e 1.6TBASE, integrando la generazione di pattern e interferenze, il condizionamento ottico sotto stress, la calibrazione, il controllo dei moduli e il rilevamento del BER per ogni lane, il tutto sotto il controllo del software di test dei ricevitori ottici.
Per saperne di più

-
![]()
Per saperne di più
Come verificare le prestazioni di una scheda di valutazione elettrica
Verificare una scheda di valutazione elettrica inviando sequenze PRBSQ attraverso i dispositivi attivi o passivi sottoposti a test, instradando i loopback attraverso il dispositivo o la scheda e misurando, linea per linea, il tasso di errore binario e il comportamento della correzione degli errori in avanti (FEC) sulle linee PAM4 ad alta velocità configurate.
Per saperne di più
-
![]()
Per saperne di più
Come verificare i ricetrasmettitori ottici da 1,6 T
Eseguire il benchmark di un ricetrasmettitore ottico da 1,6 T completamente risincronizzato attraverso percorsi di loopback ottici e lato host, configurare le modalità Ethernet supportate tramite CMIS e misurare le statistiche BER e FEC per ogni lane durante test di prestazione degli errori a livello di sistema di breve o lunga durata.
Per saperne di più

Mettetevi in contatto con uno dei nostri esperti
Avete bisogno di aiuto per trovare la soluzione giusta per voi?