Cómo validar la inferencia de IA antes de la implementación

Validar la infraestructura de inferencia antes de la implementación del hardware
Configure un entorno de validación de la inferencia de IA previo a la implementación mediante la modelización de la topología prevista del centro de datos en un gemelo digital. Representar las rutas de conmutación y enrutamiento, los servicios de inferencia, los controles de seguridad y las conexiones previstas entre el ingreso de clientes y los backends de inferencia. Configure la emulación de la carga de trabajo de inferencia de inteligencia artificial para generar indicaciones y respuestas realistas de modelos de lenguaje a gran escala, incluyendo longitudes variadas de indicaciones, patrones de turnos y usuarios simultáneos. Defina un perfil de carga de trabajo reproducible, especifique las tasas de llegada de solicitudes y elija duraciones de prueba representativas antes de poner a prueba la arquitectura modelada. Registre la latencia de respuesta de extremo a extremo, el tiempo hasta el primer token, la tasa de tokens de salida y los resultados de la finalización de las solicitudes en cada nivel de carga de trabajo. Siempre que sea posible, correlacione esas observaciones propias de la inferencia con la telemetría de la infraestructura procedente de las capas de computación, red y seguridad. Utilice entradas de carga de trabajo idénticas en todas las variantes de la arquitectura, de modo que las diferencias observadas puedan atribuirse a la configuración simulada del sistema y no a un cambio en el comportamiento de las consultas.
Realiza una prueba de referencia con un nivel bajo de usuarios simultáneos y, a continuación, aumenta la demanda emulada en pasos controlados, manteniendo la distribución de la carga de trabajo. Realice un seguimiento de los cambios en el rendimiento de los tokens, la latencia de respuesta en la cola, las tasas de finalización y la relación entre la carga ofrecida y la capacidad de inferencia proporcionada. Compare las posibles configuraciones de enrutamiento, seguridad y servicios de inferencia dentro del mismo entorno modelado; registre los detalles de configuración de cada ejecución. Examine cómo las sesiones de contexto prolongado y de múltiples turnos modifican la demanda en la ruta de inferencia modelada y en qué punto comienza a ampliarse la distribución del tiempo de respuesta. Cuando la integración permita disponer de telemetría a nivel del sistema, compare las mediciones de inferencia con el comportamiento registrado de la unidad de procesamiento gráfico, la memoria y la red. Separe las observaciones del gemelo digital de los resultados que requieran una validación física del hardware. Documente los supuestos de carga de trabajo probados, las configuraciones de software y de red, las definiciones de las mediciones y los límites observados para cada opción. Estos resultados constituyen un registro de validación repetible previo a la implementación, más que una afirmación sobre un rendimiento garantizado en producción.

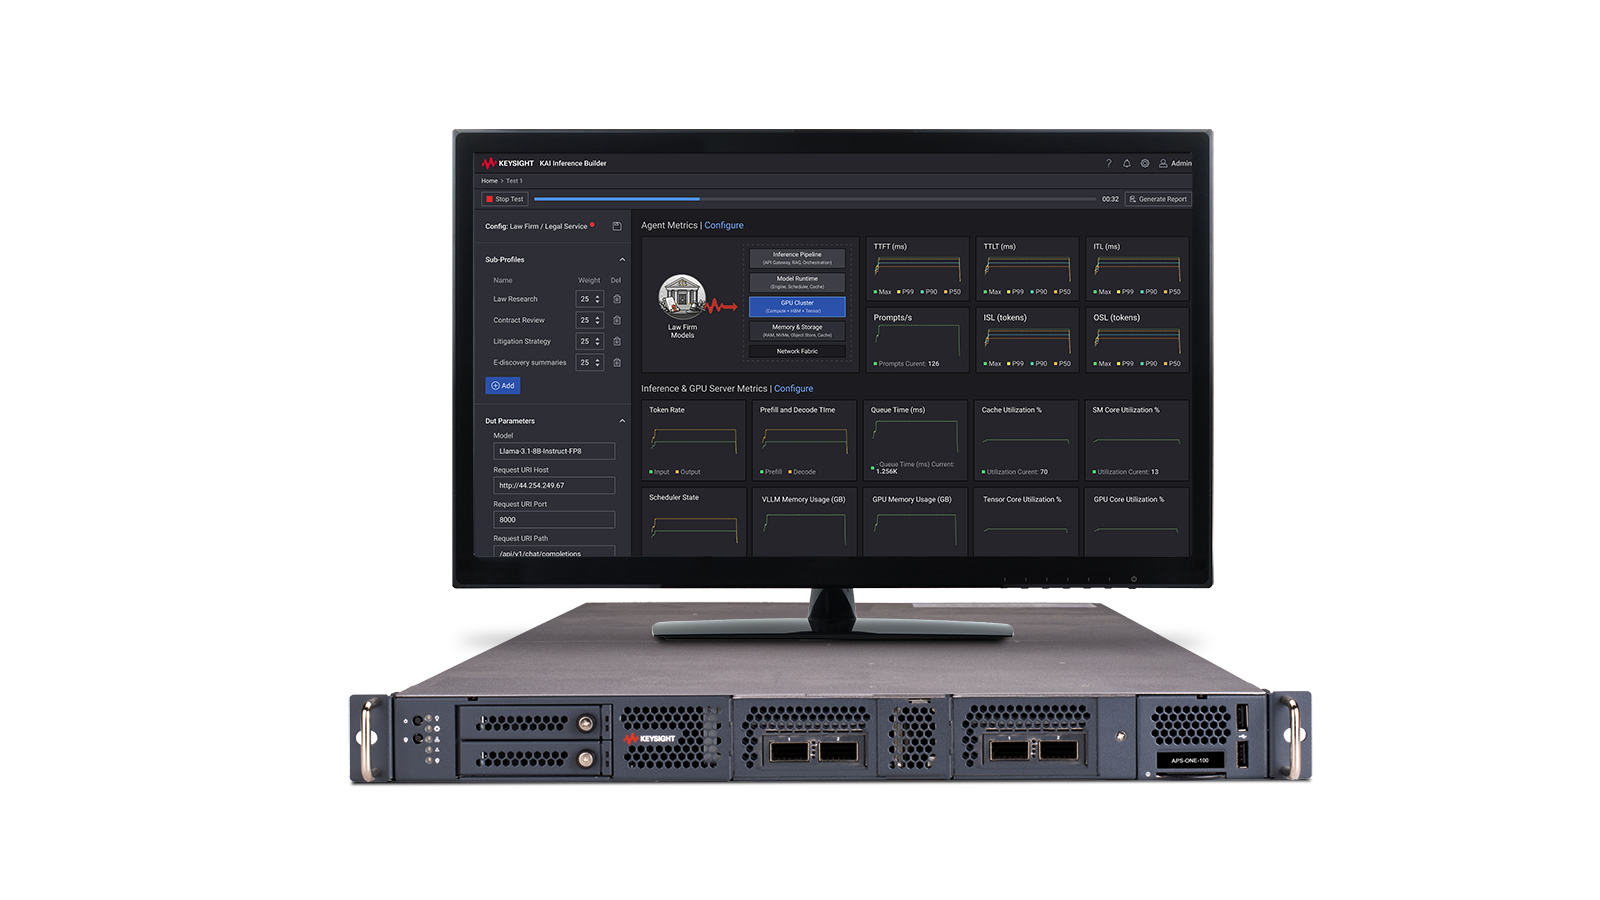
Solución de validación de la inferencia de IA previa a la implementación
Ver vídeo de demostración de la solución de validación de la inferencia de IA previa a la implementación
Descubre los productos de nuestra solución de validación de la inferencia de IA previa a la implementación
-

![]()
952-1001 Paquete KAI Inference Builder con 2 agentes y hasta 100 solicitudes por segundo


Descubra recursos e información
Recursos adicionales para la validación de la inferencia de IA previa a la implementación
Casos prácticos relacionados

-
![]()
Más información
Cómo comprobar la sensibilidad del receptor óptico 1.6T
Realizar pruebas automatizadas de sensibilidad de receptores ópticos bajo estrés para 800GBASE y 1.6TBASE mediante la integración de la generación de patrones e interferencias, el acondicionamiento óptico bajo estrés, la calibración, el control de los módulos y la detección de la tasa de errores (BER) por canal, todo ello bajo el control del software de pruebas de receptores ópticos.
Más información

-
![]()
Más información
Cómo validar el rendimiento de una placa de evaluación eléctrica
Validar una placa de evaluación eléctrica enviando patrones PRBSQ a través de los dispositivos activos o pasivos sometidos a prueba, enrutando bucles de retroalimentación a través del dispositivo o la placa, y midiendo, carril por carril, la tasa de error de bits y el comportamiento de la corrección de errores hacia adelante en los carriles PAM4 de alta velocidad configurados.
Más información
-
![]()
Más información
Cómo validar transceptores ópticos de 1,6 T
Realizar pruebas comparativas de un transceptor óptico de 1,6 T totalmente resincronizado a través de las rutas de bucle cerrado del lado del host y ópticas, configurar los modos Ethernet compatibles mediante CMIS y medir las estadísticas de BER y FEC por carril durante pruebas de rendimiento de errores a nivel de sistema, tanto de corta como de larga duración.
Más información

Póngase en contacto con uno de nuestros expertos
¿Necesita ayuda para encontrar la solución adecuada para usted?