Comment valider l'inférence IA avant le déploiement

Valider l'infrastructure d'inférence avant le déploiement du matériel
Mettez en place un environnement de validation de l’inférence IA avant le déploiement en modélisant la topologie prévue du centre de données dans un jumeau numérique. Représentez les chemins de commutation et de routage, les services d’inférence, les contrôles de sécurité et les connexions prévues entre l’entrée client et les backends d’inférence. Configurez l’émulation de la charge de travail d’inférence d’intelligence artificielle afin de générer des invites et des réponses réalistes pour les grands modèles linguistiques, en incluant des longueurs d’invite variées, des schémas d’échange et des utilisateurs simultanés. Définissez un profil de charge de travail reproductible, précisez les taux d’arrivée des requêtes et choisissez des durées de test représentatives avant de tester l’architecture modélisée. Enregistrez la latence de réponse de bout en bout, le temps jusqu’au premier token, le débit de tokens en sortie et les résultats d’exécution des requêtes à chaque niveau de charge de travail. Lorsque cela est possible, mettez en corrélation ces observations propres à l’inférence avec les données de télémétrie de l’infrastructure provenant des couches de calcul, de réseau et de sécurité. Utilisez des entrées de charge de travail identiques pour toutes les variantes d’architecture afin que les différences observées puissent être attribuées à la configuration simulée du système plutôt qu’à un changement de comportement des requêtes.
Effectuez un test de référence avec un faible nombre d'utilisateurs simultanés, puis augmentez la demande émulée par paliers contrôlés tout en préservant la répartition de la charge de travail. Suivez l’évolution du débit de jetons, de la latence de réponse en queue, des taux d’achèvement, ainsi que la relation entre la charge proposée et la capacité d’inférence fournie. Comparez les différentes configurations possibles en matière de routage, de sécurité et de services d’inférence au sein d’un même environnement modélisé ; enregistrez les détails de configuration pour chaque exécution. Examinez comment les sessions à contexte long et à plusieurs échanges modifient la demande sur le chemin d’inférence modélisé et à quel moment la distribution des temps de réponse commence à s’élargir. Lorsque l’intégration permet d’accéder à la télémétrie au niveau du système, comparez les mesures d’inférence avec les comportements rapportés concernant le processeur graphique, la mémoire et le réseau. Distinguez les observations issues du jumeau numérique des résultats qui nécessiteraient une validation matérielle physique. Documentez les hypothèses de charge de travail testées, les configurations logicielles et réseau, les définitions des mesures et les limites observées pour chaque option envisagée. Ces résultats constituent un dossier de validation reproductible avant le déploiement, et non une garantie de performances en production.

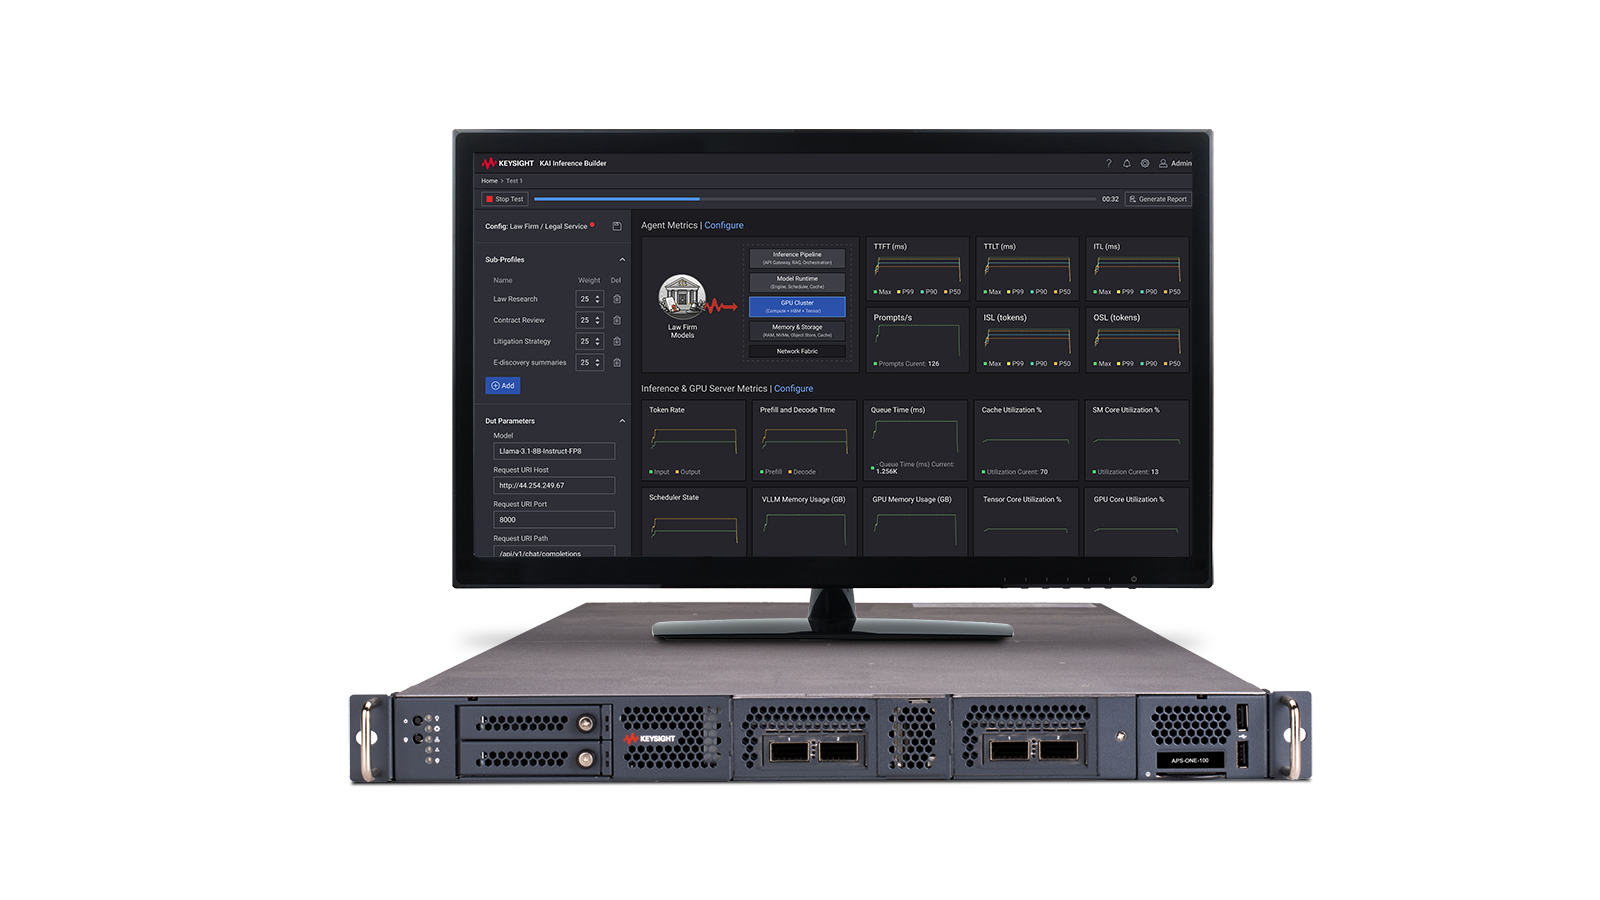
Solution de validation de l'inférence IA avant déploiement
Voir la vidéo de démonstration de la solution de validation de l'inférence IA avant déploiement
Découvrez les produits de notre solution de validation de l'inférence IA avant déploiement
-

![]()
952-1001 Pack KAI Inference Builder comprenant 2 agents et jusqu'à 100 requêtes par seconde


Découvrir les ressources et les idées
Ressources supplémentaires pour la validation de l'inférence IA avant le déploiement
Cas d'utilisation connexes

-
![]()
En savoir plus
Comment tester la sensibilité d'un récepteur optique 1,6 T
Réaliser des tests automatisés de sensibilité des récepteurs optiques sous contrainte pour les normes 800GBASE et 1,6TBASE, en intégrant la génération de motifs et d'interférences, le conditionnement optique sous contrainte, l'étalonnage, le contrôle des modules et la détection du taux d'erreurs binaires (BER) par voie, le tout sous le contrôle d'un logiciel de test des récepteurs optiques.
En savoir plus

-
![]()
En savoir plus
Comment valider les performances d'une carte d'évaluation électrique
Valider une carte d'évaluation électrique en injectant des séquences PRBSQ dans les composants actifs ou passifs soumis aux tests, en acheminant des boucles de retour à travers le composant ou la carte, et en mesurant, voie par voie, le taux d'erreurs binaires ainsi que le comportement de la correction d'erreurs sans voie de retour (Forward Error Correction) sur l'ensemble des voies PAM4 haut débit configurées.
En savoir plus
-
![]()
En savoir plus
Comment valider des émetteurs-récepteurs optiques de 1,6 T
Évaluer les performances d'un émetteur-récepteur optique 1,6 T entièrement resynchronisé via des voies de bouclage côté hôte et optiques, configurer les modes Ethernet pris en charge via CMIS, et mesurer les statistiques BER et FEC par voie lors de tests de performance en matière d'erreurs au niveau du système, de courte ou de longue durée.
En savoir plus

Contactez l'un de nos experts
Besoin d'aide pour trouver la solution qui vous convient ?