Wir denken, das dies die Seite ist, die Sie sehen wollten..
Stattdessen Suchergebnisse ansehen:
Choose a country or area to see content specific to your location
Können wir Ihnen behilflich sein?
Empfohlene Suchanfragen
No product matches found - System Exception
Passende Inhalte
-
-
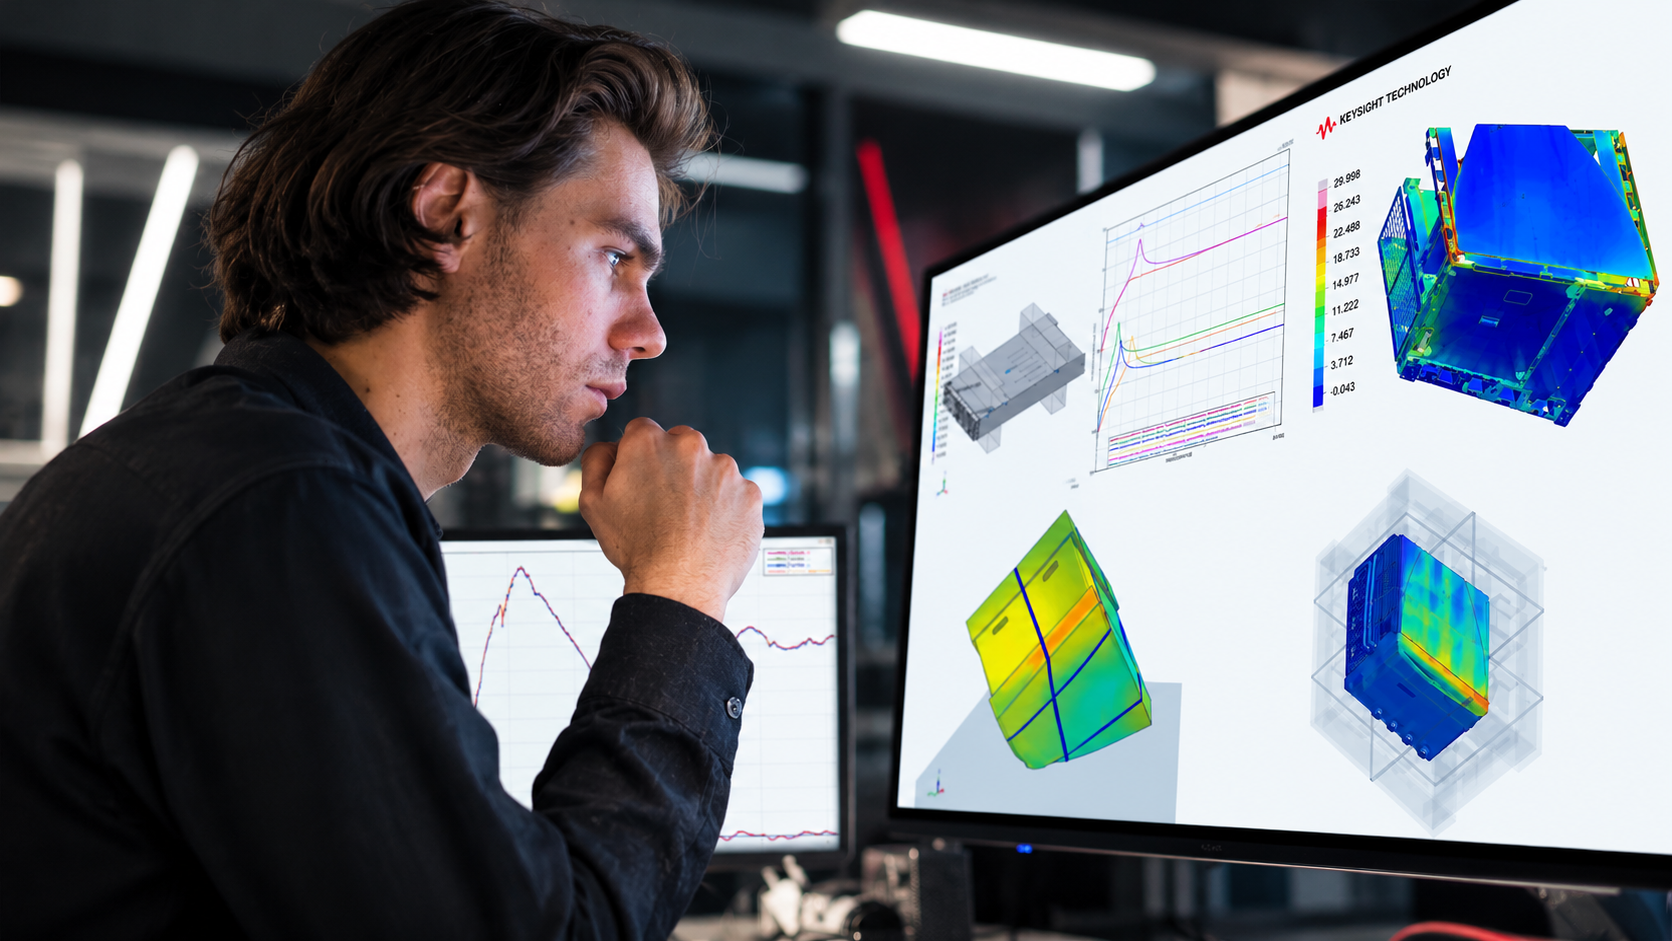
Integrierte Physik-Suite
Die Verknüpfung von Design und physikalischen Tests zur Bewertung der Fall-, Stoß- und Vibrationsfestigkeit erfolgt, bevor die Hardware existiert.

-
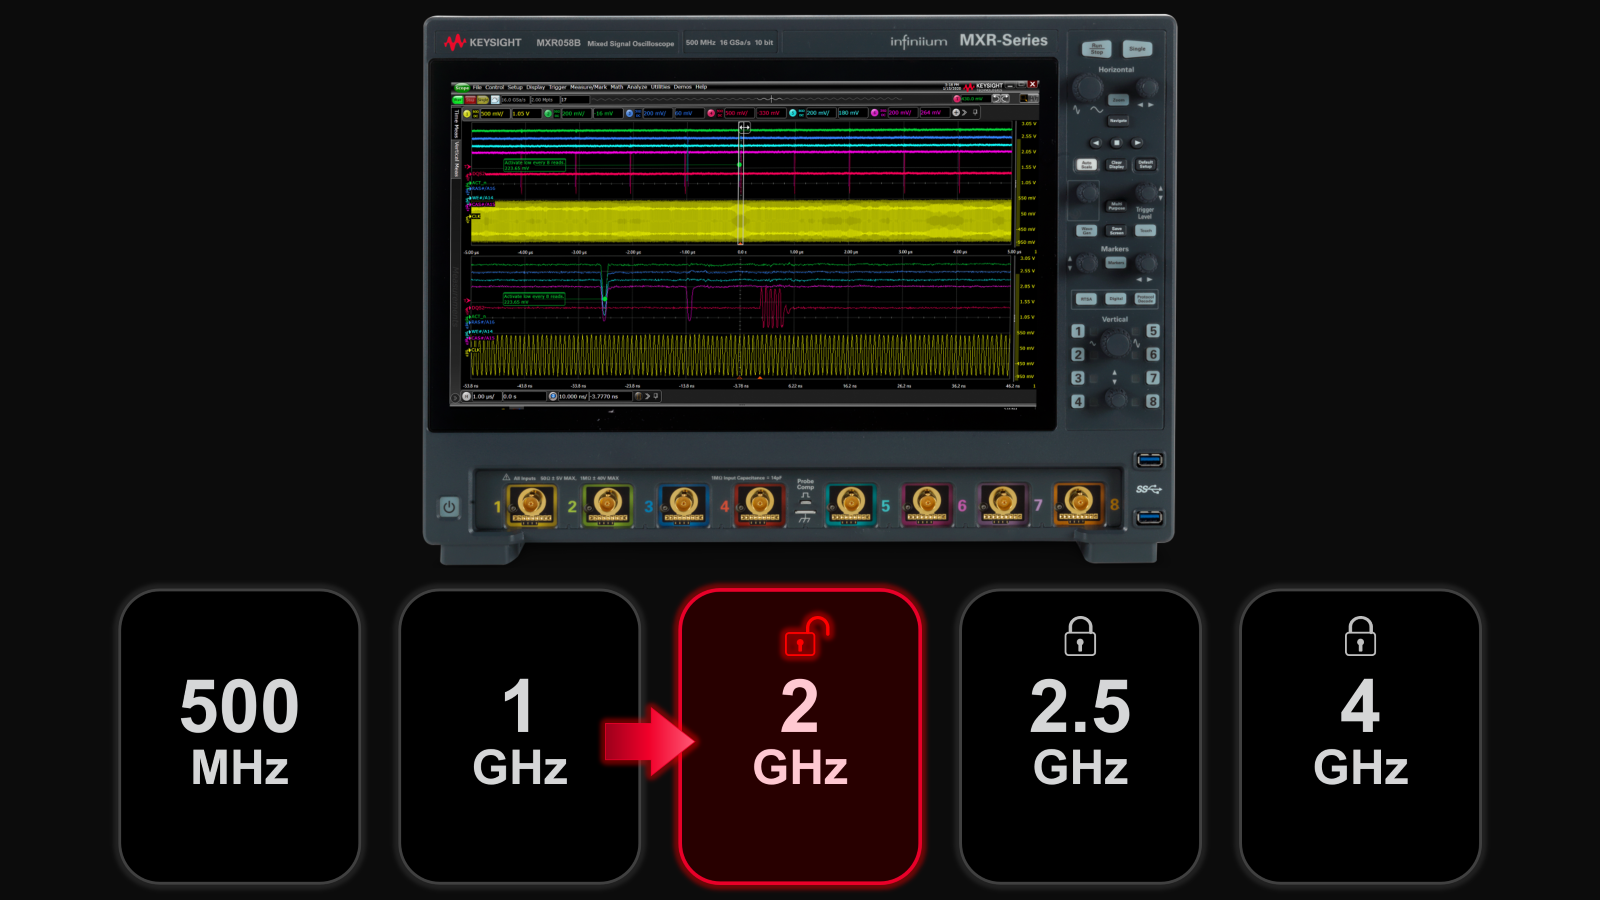
Kaufen Sie ein Expert Oszilloskop, steigern Sie Ihre Bandbreite
Sichern Sie sich Ihr kostenloses Upgrade auf die nächste Bandbreitenstufe.
-
End-to-End-Validierung für KI-Rechenzentren
Stärken 1.6T Netzwerkzuverlässigkeit für KI-Workloads im großen Maßstab, von Transceivern bis zu Verbindungsleitungen.
-
Komplexe MIMO-Signale bewältigen
Kombinieren Sie die Keysight VSA-Software mit dem neuen Signalanalysator XA5 für erweiterte Visualisierung, Demodulation und Analyse – starten Sie noch heute Ihre 30-tägige Testphase.
-
Einführung KI-gestützter Paketbroker
Mit zusätzlichem Speicher und Speicherplatz können diese verbesserten NPBs die KI-Sicherheits- und Leistungsüberwachungssoftware sowie den KI-Stack von Keysight ausführen.
-
Halbleiterinnovationen beschleunigen
Entdecken Sie durchgängige Arbeitsabläufe, die IC-Design, Validierung, Wafer-Test und Photonik umfassen.
-
Beschleunigen Sie Ihren Innovationsmotor
Informieren Sie sich über kuratierte Support-Pläne, die nach Prioritäten geordnet sind, um Ihre Innovationsgeschwindigkeit aufrechtzuerhalten.

-
-
Die richtige Verbindung ermöglicht die Messung
Maximieren Sie Genauigkeit und Leistung mit Präzisionszubehör, das speziell für Keysight-Instrumente entwickelt wurde.

Komplexe HF-Signale schneller analysierenEntdecken Sie die Möglichkeiten der Zweikanal- und Ultrabreitband-Signalanalyse für anspruchsvolle HF-Workflows.
 Digitale Validierung. Schneller.
Erhalten Sie schnellere und klarere Einblicke mit unserem neuen Multicore-12-Bit-Oszilloskop mit bis zu 33 GHz. Tauschen Sie Ihr altes Oszilloskop ein und erhalten Sie eine Gutschrift für ein neues XR8.
-
-
Maßgeschneiderte Lösungen, die speziell für die Design- und Testherausforderungen Ihrer Branche entwickelt wurden.
AusgewähltAnwendungsfälle, die jeder Phase Ihres Produktlebenszyklus zugeordnet sind, vom Design bis zum Betrieb.
Erfolgsgeschichten
HPE Juniper Networking baut KI-Infrastruktur der nächsten Generation -
Autoritative Anwendungsberichte, Datenblätter, Referenzdesigns und Testverfahren zur Beschleunigung von Design- und Validierungsentscheidungen.
AusgewähltPraxisorientierte Bootcamps, in denen Systemdesign, Testmethoden und Produktionsabläufe vermittelt werden, die Ingenieure sofort anwenden können.
Lernzentrum
KI-TechnologieErkunden Sie Methoden, Teststrategien und technische Ressourcen für die Entwicklung, Validierung und Skalierung von KI-Systemen und -Netzwerken.
-
Schneller Zugriff auf die häufigsten unterstützungsbezogenen Selbsthilfeaufgaben.
Zusätzliche Inhalte zur Unterstützung Ihrer Produktanforderungen.
Mehr erreichen mit Keysight ServicesEntdecken Sie Dienstleistungen, die jeden Schritt Ihrer Innovationsreise beschleunigen.






SPRACHE
KAI Inference Builder: KI-Inferenzinfrastrukturen validieren und optimieren
Modell: 952-1100
Kein Bild verfügbar
vorher
- Überblick
- Optionen
- Zubehör
- Software
- Unterstützung
KAI Inference Builder Bundle mit 10 Agenten und bis zu 10.000 Eingabeaufforderungen pro Sekunde
Das KAI Inference Builder Bundle umfasst 10 Agenten und bis zu 10.000 Eingabeaufforderungen pro Sekunde (1-Jahres-Abonnement, weltweit gültig). Das Bundle ist TAA-konform (952-1100).

-
Form factor
Software
-
License types
Subscription
-
Performance Level
10000 prompts per second, 100000 simulated users

Bereit für ein Angebot?
Erfahren Sie, was alles enthalten ist und welche Upgrade-Optionen von Keysight verfügbar sind.
Highlights
- Realistisches KI-Clientverhalten in großem Umfang emulieren, um ganze KI-Inferenzinfrastrukturen und -Stacks zu validieren.
- Wählen Sie verschiedene KI-Persona-Aufforderungen, die Druckpunkte in verschiedenen Phasen der KI-Inferenzpipeline auslösen.
- Validierung von KI-Inferenzinfrastrukturen, die in öffentlichen oder privaten Clouds eingesetzt werden, mit vollständig virtueller oder hardwarebasierter Inferenzclient-Emulation.
- Skalieren Sie auf Millionen von simulierten Benutzern mit detaillierter Kontrolle über die generierten Eingabeaufforderungen pro Sekunde für unübertroffene Skalierungstests von KI-Inferenz.
- Erhalten Sie detaillierte Inferenzstatistiken, um umsetzbare Erkenntnisse über potenzielle Engpässe, Grenzen und Ineffizienzen in verschiedenen Komponenten der KI-Inferenzpipeline zu gewinnen:
- GPU-Berechnung
- HBM / VRAM Speichersysteme
- KV-Cache- und Speicherschichten
- PCIe- und RDMA-Verbindungen
- Modell-Engines und Orchestratoren
- Korrelation von clientseitigen Metriken mit der Erfassung von Telemetriedaten auf Inferenzmaschinenebene (z. B. VLLM-Statistiken) und GPU-Telemetriedaten auf Systemebene (z. B. DCGM-Daten) in einer einzigen zeitlich synchronisierten Ansicht:
- Eingabeaufforderungen ser second
- Gleichzeitige Benutzer
- Zeit bis zum ersten Token (TTFT) — Maximalwert und Perzentile (z. B. P50, P90, P99)
- Zeit bis zum letzten Token (TTLT) — Maximalwert und Perzentile (z. B. P50, P90, P99)
- Token pro Sekunde (Ein-/Ausgabe)
- Cache-Nutzung
- Vorfüll- und Dekodierungszeit
- Tensor Core-Nutzung
- Planerstatus
- GPU-Leistungsaufnahme
Dienstleistungen und Support
Innovieren Sie im Handumdrehen mit maßgeschneiderten Supportplänen und priorisierten Reaktions- und Bearbeitungszeiten.
Profitieren Sie von planbaren, leasingbasierten Abonnements und umfassenden Lifecycle-Management-Lösungen – damit Sie Ihre Geschäftsziele schneller erreichen.
Als KeysightCare-Abonnent profitieren Sie von einem erweiterten Service mit zuverlässiger technischer Unterstützung und vielem mehr.
Stellen Sie sicher, dass Ihr Testsystem den Spezifikationen entspricht und sowohl lokale als auch globale Standards erfüllt.
Schnelle Messungen dank hauseigener, von Ausbildern geleiteter Schulungen und E-Learning.
Laden Sie die Keysight-Software herunter oder aktualisieren Sie Ihre Software auf die neueste Version.
Beginnen Sie Ihr Angebot, indem Sie ein Produkt auswählen
Konfiguration auswählen